Eine Million Ausgabetokens kostet bei GPT-6 Luna 0,50 US-Dollar, bei Claude Opus 5.5 dagegen 20 US-Dollar. Beim vierzigfachen Tokenpreis muss das teurere Modell schon etwas zu bieten haben.
Vergleichen Sie zwei Aufgaben: eine Bestellnummer aus einer E-Mail herauslesen und einen Fehler in einem unbekannten Repository finden. Im ersten Fall lässt sich die Antwort mit wenigen Zeilen Text abgleichen. Im zweiten kann bereits die Suche nach einer geeigneten Prüfung einen großen Teil der Arbeit ausmachen. Für beides allein wegen eines Spitzenplatzes dasselbe Modell zu kaufen, wäre eine vorschnelle Entscheidung.
Opus führt. Warum steht Luna trotzdem in der Grafik?
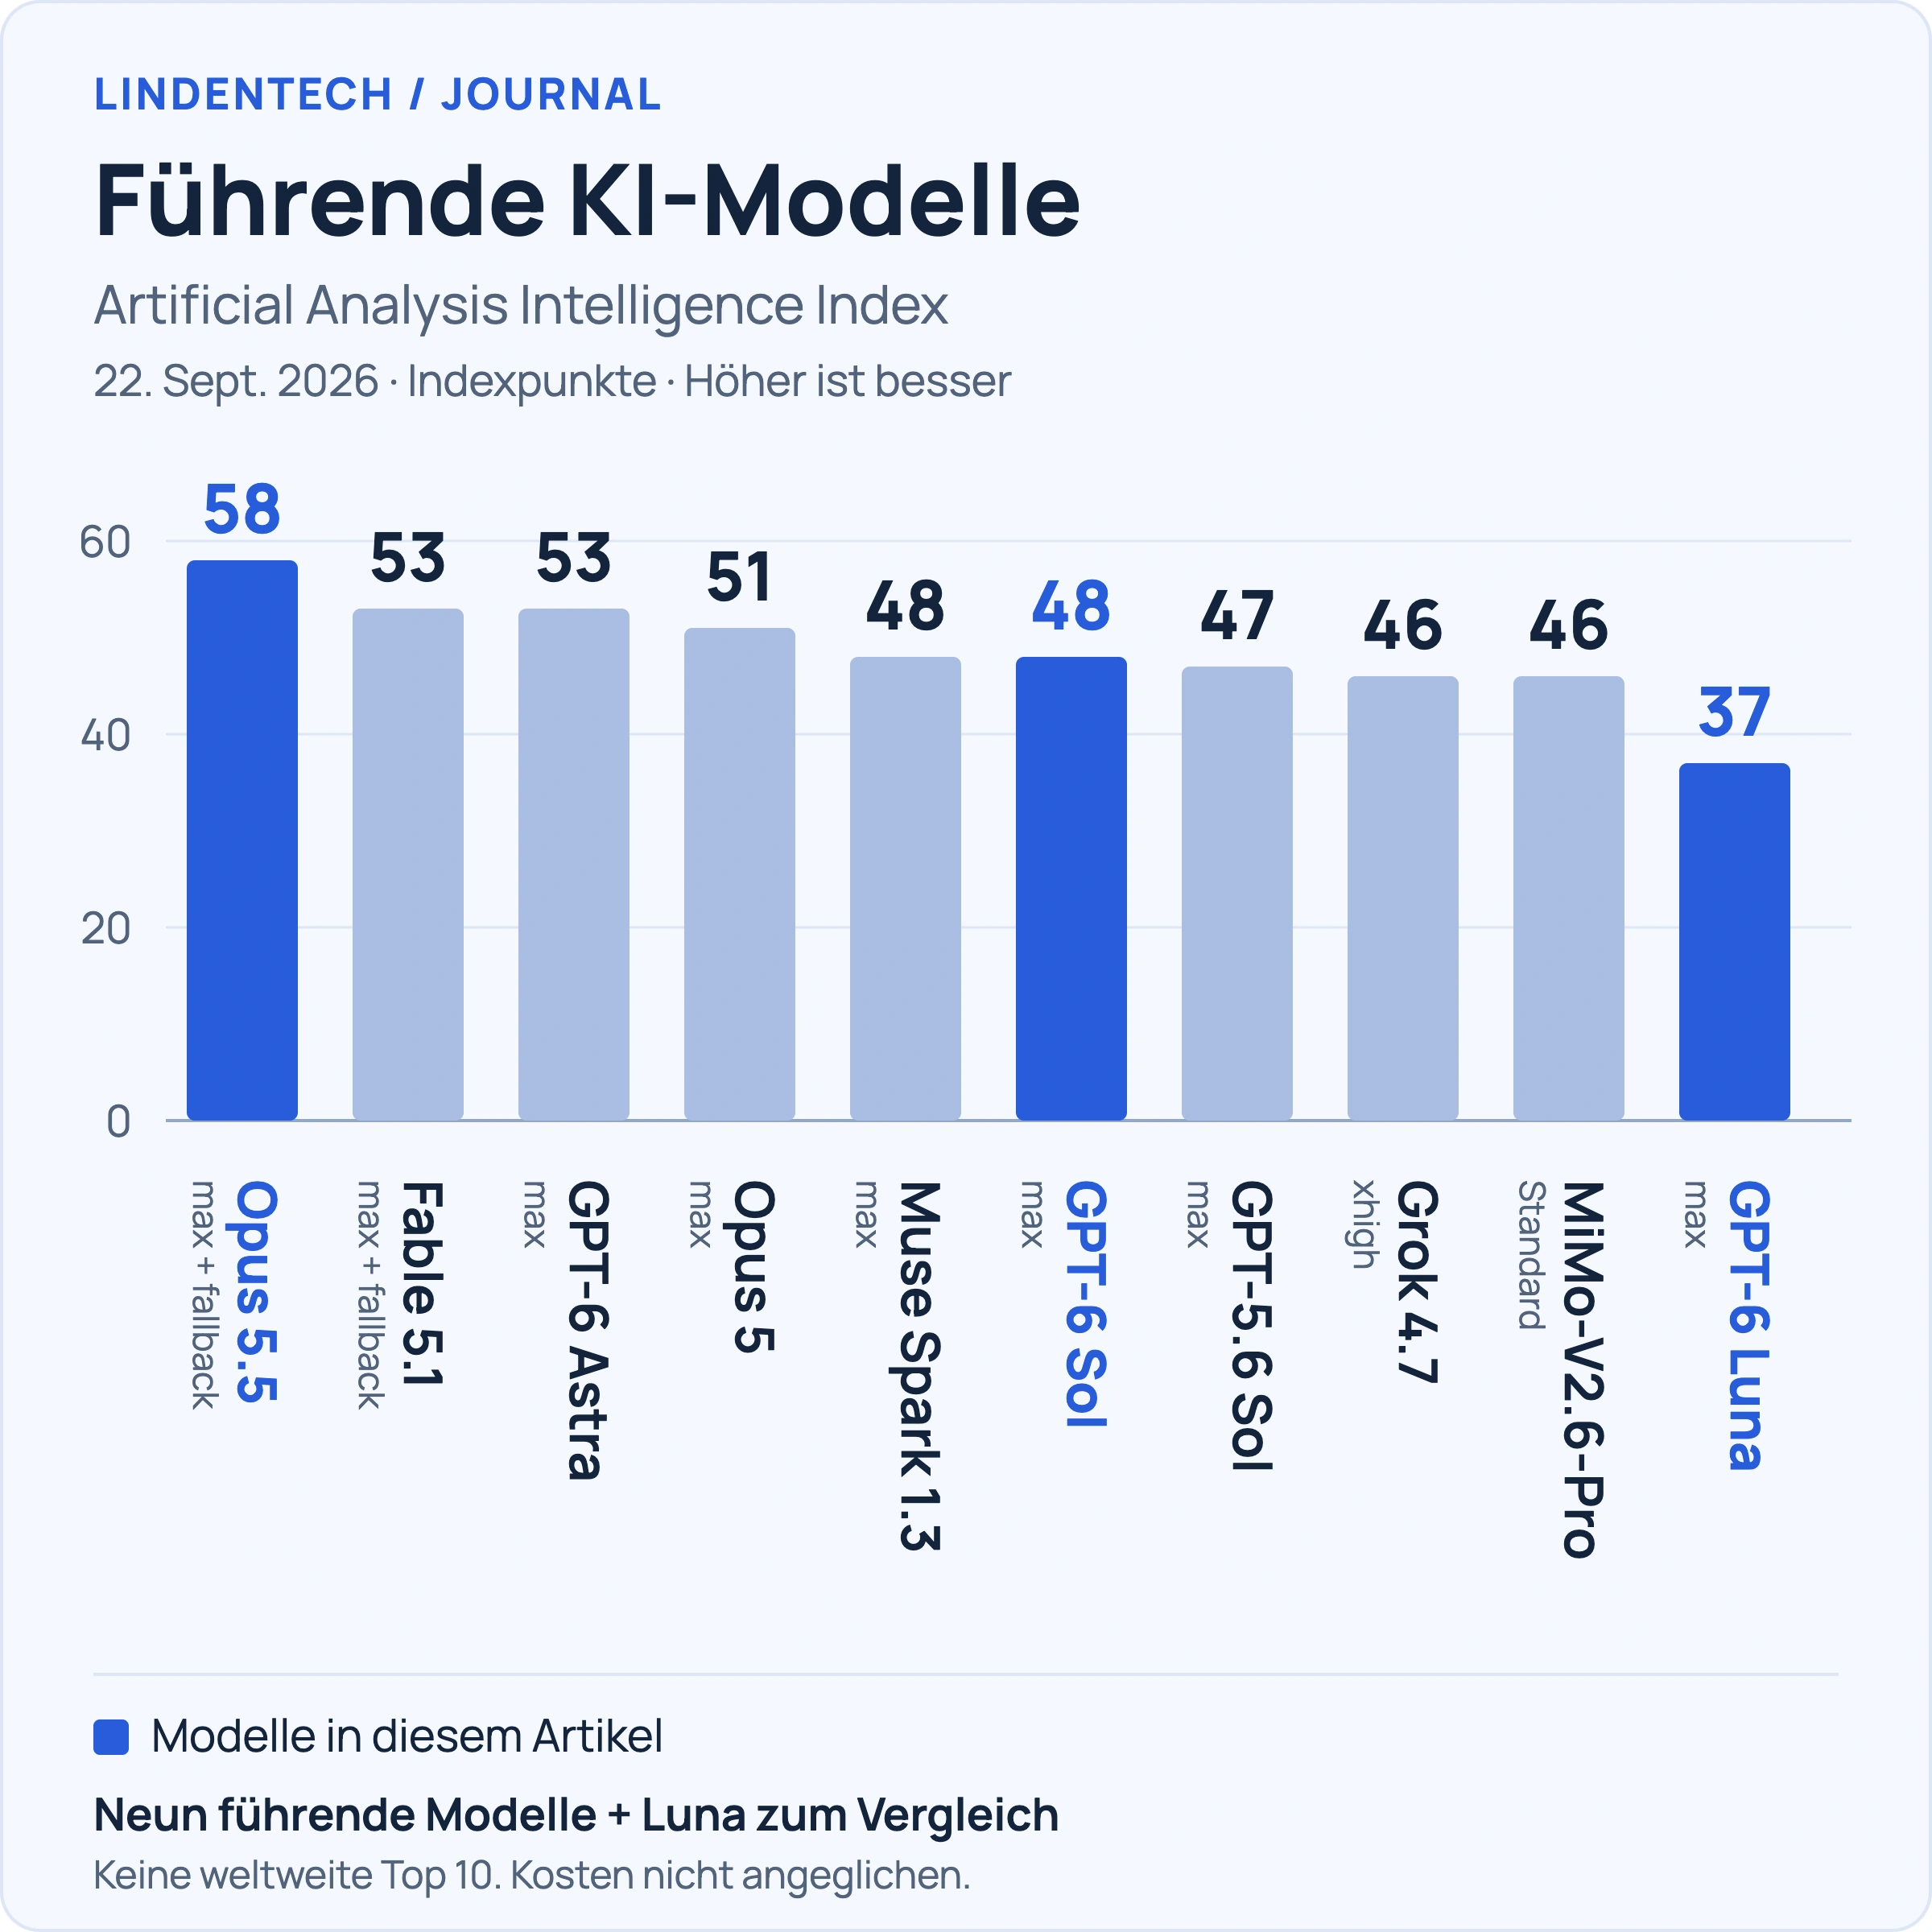
Im Artificial Analysis Intelligence Index vom 22. September 2026 erreicht Opus 5.5 einen Wert von 58. Fable 5.1 und GPT-6 Astra liegen bei 53, GPT-6 Sol bei 48 und Luna bei 37. Das sind Indexpunkte, keine Prozentangaben für erfolgreich bearbeitete Kundenanfragen.
Die Grafik zeigt neun unterschiedliche Modelle mit den höchsten Werten sowie GPT-6 Luna. Sie ist keine weltweite Top Ten: Wir haben Luna ergänzt, damit alle drei Modelle dieses Vergleichs zu sehen sind. Jedes Modell erscheint einmal mit seinem höchsten veröffentlichten Wert.
Die Beschriftung unter den Balken lohnt einen Blick. Die ausgewählten Ergebnisse für Opus 5.5 und Fable 5.1 verwenden maximalen Reasoning-Aufwand mit aktiviertem Fallback. Auch die übrigen Konfigurationen sind angegeben. Wir haben sie nicht auf gleiche Kosten oder Antwortzeiten abgestimmt. Der höchste Balken verspricht deshalb weder die kürzeste Wartezeit noch die kleinste Rechnung.
Drei Modelle für unterschiedliche Aufgaben
Anthropic beschreibt Opus 5.5 bei den meisten Aufgaben als nah an Fable 5.1, mit Verbesserungen beim Programmieren, bei der Computerbedienung und bei Wissensarbeit. Zugleich warnt das Unternehmen, dass Benchmark-Abstände die Unterschiede im Alltag weniger verlässlich abbilden als zuvor. Selbst der Anbieter empfiehlt also, sich nicht allein auf die Rangliste zu verlassen.
GPT-6 Sol ist für anspruchsvolle Programmieraufgaben und agentische Abläufe gedacht. Damit ist es ein weiterer Kandidat für das Repository-Problem. Halten Sie beim Vergleich den einstellbaren Reasoning-Aufwand fest; zwei Sol-Durchläufe müssen nicht mit denselben Einstellungen arbeiten.
GPT-6 Luna richtet sich an klar eingegrenzte Aufgaben in großer Zahl. Datenextraktion oder Klassifikation bieten sich für einen Test an. Ob Luna die richtige Bestellnummer findet, lässt sich an der E-Mail selbst besser prüfen als aus 37 Indexpunkten ableiten.
Die Nacharbeit steht nicht in der Preisliste
Die offiziellen Standardtarife für Texttokens, geprüft am 22. September 2026, gelten jeweils in US-Dollar pro Million Tokens:
- Opus 5.5: 4 für Eingabe, 20 für Ausgabe; 0,20 für Cache-Lesezugriffe.
- GPT-6 Sol: 2 für Eingabe, 10 für Ausgabe; 0,20 für zwischengespeicherte Eingabe.
- GPT-6 Luna: 0,10 für Eingabe, 0,50 für Ausgabe; 0,01 für zwischengespeicherte Eingabe.
Bei OpenAI gelten zusätzliche Preisbedingungen für lange Prompts, Verarbeitungsmodi und regionale Verarbeitung. Der vierzigfache Tokenpreis bedeutet zudem nicht automatisch vierzigfache Kosten pro erledigter Aufgabe: Tokenverbrauch und erneute Versuche verändern die Rechnung.
Anthropics eigene Zahlen zeigen den Unterschied. Laut Ankündigung liegen die Preise für Eingabe- und Ausgabetokens von Opus 5.5 um 20 % unter denen von Opus 5. Für typische Aufgaben bei Standardeinstellungen schätzt das Unternehmen die Kosten auf Basis eigener Tests dagegen als 40 % niedriger ein. Die erste Zahl beschreibt den Tarif, die zweite die erwarteten Kosten der Arbeit.
Muss ein Mitarbeiter die Antwort umschreiben, fehlt ein Teil des Aufwands auf der API-Rechnung. Rechnen Sie diese Zeit, erneute Versuche und Tool-Aufrufe mit ein. Unser Beitrag zu den Kosten eines KI-Assistenten behandelt die umfassendere Kalkulation.
Ein Modellwechsel kann einen funktionierenden Agenten lahmlegen
Die Migrationshinweise zu Opus 5.5 enthalten ein weniger spektakuläres Detail als die Benchmark-Werte: Der Denkmodus ist immer aktiv, und erzwungene Tool-Nutzung führt zu Fehlern. Ein Agent, der auf einen solchen Aufruf angewiesen ist, kann deshalb Probleme bekommen, bevor Sie die Qualität seiner Antwort überhaupt beurteilen können.
Beginnen Sie mit einem umkehrbaren Ablauf: einem Vorschlag zur Weiterleitung einer Support-Anfrage, den ein Mitarbeiter bestätigt, oder einer Codeänderung, die noch Tests und Review bestehen muss. Vergleichen Sie mit dem bisherigen Modell unter denselben Anweisungen, Werkzeugen und Berechtigungen. Nehmen Sie unklare Anfragen und Dienstausfälle in den Test auf, nicht nur saubere Beispiele. Erfassen Sie Antwortzeit und manuelle Korrekturen, ohne dem Agenten mehr Zugriffsrechte zu geben.
Wann sich der Aufpreis lohnt
Steht die Bestellnummer bereits in Ihrem System, genügt vielleicht eine Datenbankabfrage. Auch eine feste Extraktionsregel kommt infrage. Prüfen Sie Automatisierung ohne KI, bevor Sie dafür ein Modell bezahlen.
Beim Fehler im Repository kann ein höherer Tokenpreis sinnvoll sein, wenn dadurch weniger Arbeit bis zum richtigen Ergebnis nötig ist. Vergleichen Sie die Kosten der erledigten Aufgabe, einschließlich der Arbeitszeit Ihrer Mitarbeiter.
Wenn Sie über einen Modellwechsel nachdenken, besprechen wir den Ablauf bei LindenTech. Beginnen Sie mit einer Aufgabe, die Ihr Team bereits Zeit kostet. Behalten Sie das bisherige Modell, solange der Wechsel seinen Aufwand nicht rechtfertigt.