Zwischen dem 9. und 12. November 2026 sind fünf große Sprachmodelle erschienen oder allgemein verfügbar geworden: Claude Fable 5.2 von Anthropic, Muse Ember von Meta, Gemini 4 Carbon und Gemini 4 Hydrogen von Google sowie eine Vorschau von Qwen4-Max bei Alibaba. Das stärkste Modell bleibt Fable 5.2, das günstigste ist Muse Ember. Für die meisten Unternehmen ist Gemini 4 Hydrogen die wichtigste Nachricht: Es löst Gemini 3.8 Flash ab, und eine Aufgabe kostet im unabhängigen Vergleich nur noch rund ein Viertel. Zwei Termine sollten Sie notieren: Am 30. November endet der Einführungspreis von Gemini 4 Carbon, am 1. Januar 2027 verdoppelt sich der Preis von Gemini 3.8 Flash.
Stand: 13. November 2026. Grundlage sind Ankündigungen, Preislisten und Modellseiten der Hersteller sowie die Rangliste von Artificial Analysis. Dieser unabhängige Anbieter testet alle Modelle mit denselben neun Aufgabenpaketen und veröffentlicht neben dem Indexwert auch die Kosten pro Aufgabe. Werte aus den Ankündigungen sind Messungen der Hersteller und als solche gekennzeichnet. LindenTech hat die neuen Modelle noch nicht in eigenen Projekten gemessen.
| Modell | Preis pro Mio. Tokens, Ein- / Ausgabe | Wofür |
|---|---|---|
| Claude Fable 5.2 | 8 $ / 40 $ | lange, schwierige Aufgaben |
| Gemini 4 Carbon | 2 $ / 10 $, ab 1. Dezember 4 $ / 20 $ | schwierige Aufgaben, Planung |
| Gemini 4 Hydrogen | 1,50 $ / 7,50 $ | Alltagsarbeit, Agenten |
| Muse Ember | 0,10 $ / 0,50 $ | Massenaufgaben, Extraktion |
| Qwen4-Max Preview | nur im Abo, bis 25.11. | Test in Coding-Tools |
Was kostet eine Aufgabe? Die neuen Modelle im Index
Der Tokenpreis sagt wenig über die Rechnung, denn Modelle verbrauchen für dieselbe Aufgabe sehr unterschiedlich viele Tokens. Aussagekräftiger sind die Kosten pro erledigter Aufgabe. Aus der Rangliste von Artificial Analysis haben wir die neuen Modelle und ihre wichtigsten Konkurrenten herausgezogen.
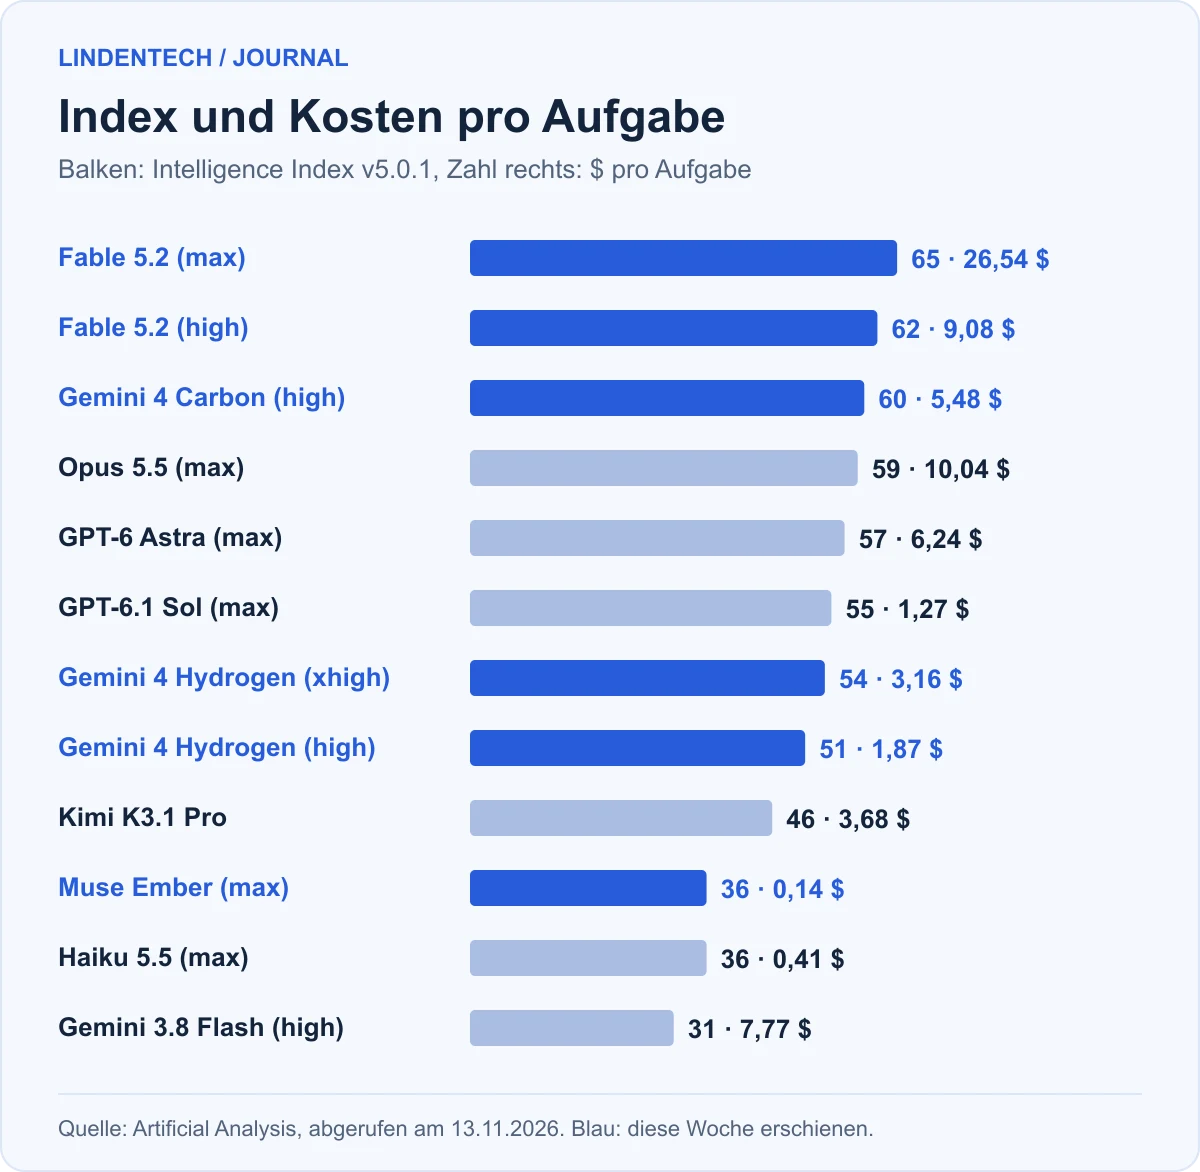
Für die Modellwahl sind die Abstände unterhalb des ersten Platzes aufschlussreicher als der Sieger. Gemini 4 Hydrogen erreicht auf seiner Standardstufe high 51 Punkte für 1,87 $ pro Aufgabe. Gemini 3.8 Flash, das Modell, das Hydrogen ablöst, kommt auf 31 Punkte für 7,77 $. Obwohl ein Hydrogen-Token doppelt so viel kostet, ist die Aufgabe also gut viermal günstiger. Auch beim Tempo liegt Hydrogen vorn: 7,9 Minuten pro Aufgabe gegenüber 14,7 Minuten. Das ist knapp doppelt so schnell; Google nennt für eigene Tests das 2,5-Fache.
Muse Ember und Claude Haiku 5.5 erreichen beide 36 Punkte. Ember kostet dafür 0,14 $ pro Aufgabe, Haiku 0,41 $, also fast das Dreifache. Meta beruft sich in der Ankündigung auf genau diese Messung.
Bei Fable 5.2 lohnt der Blick auf die Effort-Stufen. Auf max erreicht das Modell 65 Punkte für 26,54 $, auf high 62 Punkte für 9,08 $. Die letzten drei Punkte kosten fast das Dreifache, und auch auf high liegt Fable 5.2 noch vor allen anderen Modellen der Liste. Gemini 4 Carbon kommt auf high mit 60 Punkten für 5,48 $ auf das Niveau von Opus 5.5 auf max (59 Punkte, 10,04 $), zu gut der Hälfte der Kosten.
Ein Indexwert ist ein Durchschnitt über neun Aufgabenpakete aus Programmierung, Recherche und Büroarbeit. Er zeigt, welche Modelle in die engere Wahl gehören. Ob ein Modell Ihre Rechnungsprüfung oder Ihre Kundenanfragen zuverlässig erledigt, zeigt erst ein Test mit Ihren eigenen Fällen.
Gemini 4 Carbon: stark, aber nur bis 30. November günstig
Google hat Carbon am 28. Oktober angekündigt und zunächst nur Sicherheitsteams freigegeben. Seit dem 10. November steht es allen zahlenden Entwicklern und Unternehmen über die Gemini API und Gemini for business zur Verfügung, Privatkunden im Abo Google AI Ultra. Eine kostenlose Stufe gibt es nicht.
Laut Preisliste kostet Carbon bis zum 30. November 2 $ pro Million Eingabetokens und 10 $ pro Million Ausgabetokens. Ab 1. Dezember sind es 4 $ und 20 $, pro Token genauso viel wie Opus 5.5. Bei gleichem Tokenverbrauch verdoppeln sich damit auch die Kosten pro Aufgabe. Wer Carbon testen will, tut das am günstigsten in den nächsten zwei Wochen.
Google empfiehlt Carbon selbst nicht als Standard. Für die meisten Programmier- und Wissensaufgaben bleibe Gemini 4 Argon die richtige Wahl, Carbon sei für Aufgaben an der Grenze des Machbaren gedacht und verbrauche dafür mehr Tokens. Die Rangliste zeigt ein anderes Bild: Argon erreicht auf high 50 Punkte für 4,97 $, Carbon 60 Punkte für 5,48 $. Zehn Punkte mehr kosten im Test also rund 10 % mehr. Google hebt bei Carbon außerdem Sicherheitsaufgaben hervor, etwa 88,2 % im Test SEC-bench Pro zum Auffinden von Schwachstellen; auch das ist eine Herstellerangabe.
Gemini 4 Hydrogen: die neue Standardwahl bei Google
Hydrogen ist am 12. November erschienen und kostet 1,50 $ pro Million Eingabetokens und 7,50 $ pro Million Ausgabetokens, gleich über das gesamte Kontextfenster von einer Million Tokens. Google bezeichnet es in der Entwicklerdokumentation als empfohlenen Nachfolger von Gemini 3.8 Flash. Laut Google löst Hydrogen im Terminal-Bench 4.1 57 % der Aufgaben, 3.8 Flash 18,2 %.
Hydrogen ersetzt nicht nur Flash. Auf high erreicht es mit 51 Punkten den Indexwert von Argon (50) für gut ein Drittel der Kosten pro Aufgabe. Für Alltagsaufgaben im Google-Ökosystem ist es damit die naheliegende erste Wahl.
Der Umstieg ist mehr als eine neue Modell-ID. Hydrogen denkt standardmäßig auf der Stufe high, die Parameter temperature, top_p und top_k werden ignoriert, und explizites Caching entfällt. Prüfen Sie deshalb vor der Umstellung, ob Ihre Prompts und Kostenschätzungen auf diesen Einstellungen beruhen. Eine kostenlose Stufe gibt es, dort nutzt Google die Eingaben aber zur Produktverbesserung. Für Geschäftsdaten kommt nur die bezahlte Stufe in Frage.
Muse Ember: Haiku-Niveau für ein Drittel
Meta hat Muse Ember am 9. November als sein kleinstes und effizientestes Modell vorgestellt. Es kostet 0,10 $ pro Million Eingabetokens und 0,50 $ pro Million Ausgabetokens, bei Anfragen über 200.000 Tokens das Dreifache. Das Kontextfenster umfasst eine Million Tokens. Ember läuft über die Meta Model API, in Muse Code sowie bei Google Cloud und Oracle Cloud. Die Gewichte sind nicht offen.
Meta positioniert Ember für Arbeit, die Agenten den ganzen Tag wiederholen: Tool-Aufrufe, Weiterleitung, Datenextraktion und das Auswerten langer Dokumente. Nach Metas eigenen Messungen löst Ember im Test AutomationBench-AA für Geschäftsabläufe 37,8 % der Aufgaben, Haiku 5.5 13,9 % und GPT-6 Luna 20,2 %. Beim Programmieren liegt Haiku vorn: Im FrontierCode 2.0-AA kommt Ember auf 27,2 %, Haiku auf 34,9 %.
Fable 5.2 und Qwen4-Max in Kürze
Claude Fable 5.2 führt den Index an und kostet 8 $ / 40 $ pro Million Tokens. Benchmarks, Rechenbeispiele und die Frage, wann Opus 5.5 genügt, haben wir in unserem Beitrag zu Claude Fable 5.2 aufgeschlüsselt. Bis 16. November ist Fable noch in den Plänen Claude Pro und Team enthalten.
Qwen4-Max ist am 11. November als Vorschau erschienen und wird laut Alibaba nach dem 25. November wieder abgeschaltet. Zugang gibt es nur über das Abo Token Plan ab 6 $ im Monat, für Neukunden ab 3 $. Alibaba erlaubt die Nutzung ausdrücklich nur interaktiv in Coding- und Agenten-Tools, nicht für Automatisierungen oder eigene Anwendungen. Benchmarks und eine Modellkarte gibt es noch nicht. Für Geschäftsprozesse ist Qwen4-Max deshalb ein Ausblick, kein Kandidat.
Am 17. November folgte OpenAI mit GPT-6.2 Astra und Sol. Was beide kosten und wo sie Fable 5.2 schlagen, steht in unserer Einordnung von GPT-6.2.
Das gemeinsame Muster: Ein großes Modell plant, ein kleines arbeitet
Drei Hersteller geben unabhängig voneinander denselben Rat. Anthropic empfiehlt Opus 5.5 als Ausgangspunkt und Fable 5.2 als Berater für schwierige Einzelfragen. Google beschreibt Carbon als Koordinator, der plant und Hindernisse löst, während Hydrogen Code ändert, Tests ausführt und Teilaufgaben parallel erledigt. In Googles Entwicklerumgebung Antigravity erreichte diese Kombination laut Google fast die Erfolgsquote von Carbon allein, mit 24 % weniger Kontingent und 19 % schneller. Meta empfiehlt Ember zusammen mit dem großen Modell Muse Wonder.
Für Ihr Unternehmen heißt das: Die Frage lautet nicht mehr, welches Modell das beste ist, sondern welches Paar. Der Kostenunterschied ist groß. Eine Indexaufgabe kostet mit Ember 0,14 $, mit Fable 5.2 auf high 9,08 $, rund 65-mal so viel. Jeder Schritt, den das kleine Modell zuverlässig schafft, spart also fast den ganzen Betrag. Messen Sie deshalb an Ihren eigenen Fällen, welchen Anteil der Schritte das kleine Modell ohne Nacharbeit erledigt.
Fristen: Was sich bis Januar ändert
| Datum | Was sich ändert | Was Sie tun können |
|---|---|---|
| 16.11.2026 | Fable-Aktion in Claude Pro und Team endet | Test mit einer echten Aufgabe jetzt |
| 25.11.2026 | Qwen4-Max Preview wird abgeschaltet | nicht in Abläufe einbauen |
| 30.11.2026 | Carbon und Argon letztmals zu 2 $ / 10 $ | Carbon jetzt testen |
| 1.12.2026 | Carbon und Argon kosten 4 $ / 20 $ | Budget neu rechnen |
| 1.1.2027 | Gemini 3.8 Flash kostet 1,50 $ / 7,50 $ | auf Hydrogen umstellen |
Ab Januar kostet Gemini 3.8 Flash pro Token genauso viel wie Hydrogen, liefert im Index aber 20 Punkte weniger. Spätestens dann gibt es keinen Grund mehr, bei Flash zu bleiben.
Datenschutz: Was die Ankündigungen nicht sagen
Keine der fünf Ankündigungen sagt, wo Daten verarbeitet und wie lange sie gespeichert werden. Die Antworten stehen, soweit es sie gibt, in den Unterlagen dahinter.
Bei Google laufen Hydrogen und Carbon über Vertex AI mit Verarbeitung in der Multiregion „eu“, also innerhalb der EU-Mitgliedstaaten. Einzelne Regionen wie Frankfurt führt die Übersicht zur Datenresidenz für diese Modelle nicht. In der bezahlten Gemini API verwendet Google Eingaben laut Nutzungsbedingungen nicht zur Produktverbesserung, speichert sie aber für eine begrenzte Zeit zur Missbrauchserkennung, möglicherweise auch außerhalb der EU. Für Anwendungen mit Nutzern im EWR sind nur die bezahlten Dienste erlaubt.
Fable 5.2 verlangt eine Speicherung von 30 Tagen, einen Modus ohne Speicherung gibt es nur mit Freigabe durch Anthropic. Qwen4-Max verarbeitet Anfragen global mit Zugang über Singapur. Für Muse Ember fanden wir auf Metas Entwicklerseiten keine Angaben zu Speicherdauer, Training mit Kundendaten oder Verarbeitungsort. Klären Sie diese Punkte schriftlich, bevor personenbezogene Daten an eines der Modelle gehen.
Häufige Fragen
Welches KI-Modell ist im November 2026 das stärkste?
Claude Fable 5.2. Im Index von Artificial Analysis erreicht es 65 Punkte, vor Gemini 4 Carbon mit 60 und Opus 5.5 mit 59. Es ist aber auch das teuerste: 26,54 $ pro Testaufgabe auf der höchsten Stufe.
Welches neue Modell ist am günstigsten?
Muse Ember von Meta mit 0,10 $ pro Million Eingabetokens und 0,50 $ pro Million Ausgabetokens. Im Index kostet eine Aufgabe 0,14 $ bei derselben Punktzahl wie Claude Haiku 5.5, das dafür 0,41 $ braucht.
Lohnt sich der Umstieg von Gemini 3.8 Flash auf Gemini 4 Hydrogen?
Nach den Zahlen von Artificial Analysis ja: 51 statt 31 Punkte bei rund einem Viertel der Kosten pro Aufgabe. Ab 1. Januar 2027 kosten beide pro Token gleich viel. Testen Sie vorher, ob Ihre Integration auf temperature oder explizitem Caching beruht.
Ab wann wird Gemini 4 Carbon teurer?
Ab 1. Dezember 2026. Dann steigt der Preis von 2 $ / 10 $ auf 4 $ / 20 $ pro Million Tokens. Gemini 4 Argon verdoppelt sich zum selben Termin.
Kann ich die neuen Modelle mit Kundendaten aus der EU nutzen?
Bei Google ja, über Vertex AI in der Multiregion „eu“ oder über die bezahlte Gemini API mit den dort genannten Einschränkungen. Bei Fable 5.2 gilt eine Speicherung von 30 Tagen. Für Muse Ember fehlen öffentliche Angaben, hier sollten Sie vor dem Einsatz beim Anbieter nachfragen.
Wenn Sie wissen wollen, welches Modellpaar für einen Ihrer Abläufe am wenigsten pro erledigter Aufgabe kostet, sprechen Sie mit LindenTech. Bringen Sie einen konkreten Ablauf mit, das Modell, das Sie heute nutzen, und das monatliche Volumen.