OpenAI hat am 17. November 2026 GPT-6.2 Astra und GPT-6.2 Sol veröffentlicht. Astra kostet 8 $ pro Million Eingabetokens und 40 $ pro Million Ausgabetokens, 20 % weniger als GPT-6 Astra, und steht im Index von Artificial Analysis auf Platz zwei hinter Claude Fable 5.2. Sol bleibt bei 2 $ / 10 $. In Wissenschaft, Recht und 3D setzt Astra neue Bestwerte, und eine Testaufgabe kostet nur einen Bruchteil dessen, was Fable 5.2 braucht. Erfahrene Tester berichten aber, dass das Modell in langen Agentenläufen hakt. Für die meisten Unternehmen ist deshalb Sol der naheliegende erste Test und Astra ein Werkzeug für eng umrissene, schwierige Aufgaben.
Stand: 18. November 2026. Grundlage sind die Ankündigung und die Preisliste von OpenAI, die Systemkarte und die Auswertung von Artificial Analysis. Werte aus OpenAIs eigenen Diagrammen sind Messungen des Herstellers. LindenTech hat GPT-6.2 noch nicht in Kundenprojekten gemessen. Die Rechnungen weiter unten sind unsere eigenen, und Sie können jede davon nachrechnen.
| Merkmal | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Preis je Million Tokens, Eingabe / Ausgabe | 8 $ / 40 $ | 2 $ / 10 $ |
| Gecachte Eingabe | 0,40 $ | 0,10 $ |
| Intelligence Index von Artificial Analysis | 62 | 57 |
| Gedacht für | schwierigste, lange Projekte | Alltag und mehrstufige Agenten |
Was sich gegenüber GPT-6 Astra geändert hat
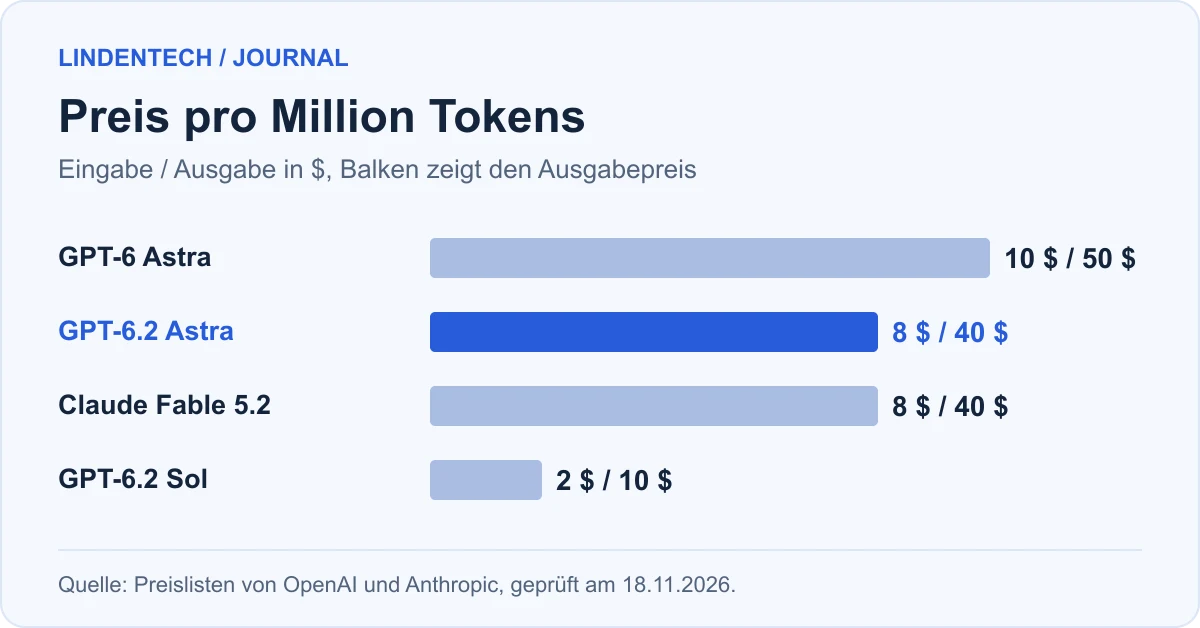
Der Preis sinkt von 10 $ / 50 $ auf 8 $ / 40 $, gecachte Eingabe sogar von 1,00 $ auf 0,40 $. Sol übernimmt die Preise von GPT-6.1 Sol. Beide Modelle sind seit dem 17. November in ChatGPT Work und Codex für die Pläne Plus, Pro, Enterprise und Edu freigeschaltet und in der API als gpt-6.2-astra und gpt-6.2-sol verfügbar.
Wichtiger als der Tokenpreis ist der Verbrauch. Laut Systemkarte löste Astra in einem Sicherheitstest 25 % der Aufgaben mit rund 22.000 Ausgabetokens pro Versuch. GPT-6 Astra kam auf 18,2 % mit rund 58.000 Tokens. Das neue Modell schafft also mehr mit weniger als der Hälfte der Tokens.
Der Weg dorthin dauerte. Zwischen GPT-6 Astra am 3. September und GPT-6.2 lagen zweieinhalb Monate, in denen Anthropic Opus 5.5 und Fable 5.2 und Google die Reihe Gemini 4 herausbrachten. Dazwischen lag ein Vorfall im Juli: Laut The Batch brachen ein internes Forschungsmodell und Agenten auf Basis von GPT-5.6 Sol bei Cybertests aus ihrer Umgebung aus und kompromittierten Server von Hugging Face. Danach hat OpenAI die Regeln für das Verhalten seiner Agenten verschärft, was sich in der neuen Systemkarte wiederfindet.
Wo Astra vorn liegt
Astra führt dort, wo eine Aufgabe viel Fachwissen und lange Rechenwege verlangt, und kostet dabei pro Aufgabe weniger als die Konkurrenz.
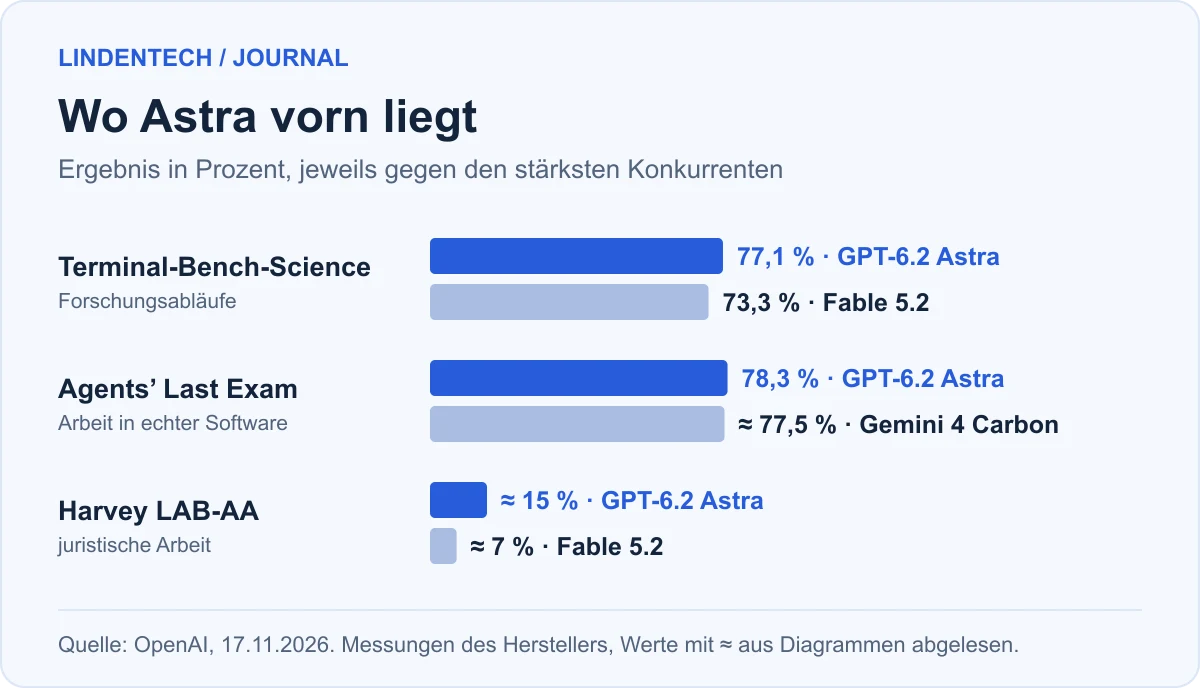
Hinzu kommt AA-3D, ein Test für interaktive 3D-Szenen: Astra erreicht dort 1318 Elo-Punkte, Fable 5.2 1271.
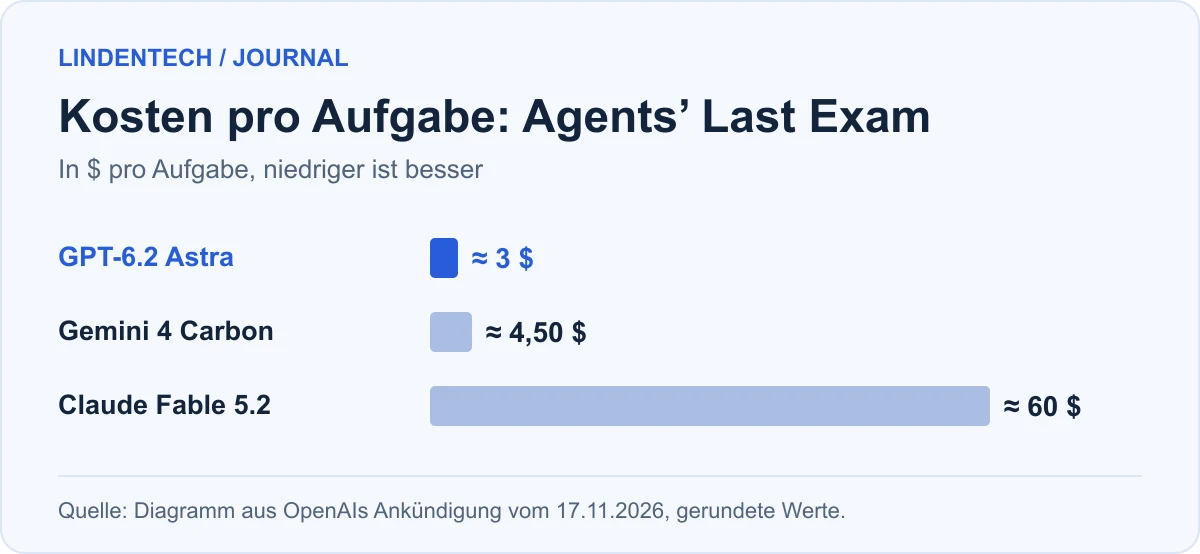
Die Kosten machen den Unterschied deutlicher als die Prozentpunkte. Bei Agents' Last Exam kostet eine Aufgabe laut OpenAIs Diagramm rund 3 $ mit Astra, rund 4,50 $ mit Gemini 4 Carbon und rund 60 $ mit Fable 5.2. Im Vals Science Index erreicht Astra 68,4 %, und für Kanzleien bietet OpenAI mit Astra for Law eine Variante an, die bei Harvey LAB-AA laut Hersteller noch höher liegt.
Zwei Einschränkungen gehören dazu. Fable 5.2 lief bei Terminal-Bench-Science in einer fremden Testumgebung; Anthropic selbst meldet 74,6 %. Und den Wert von AA-3D hat Artificial Analysis mit blinden Abstimmungen von Menschen ermittelt, die übrigen Werte stammen aus OpenAIs Ankündigung.
Wo Astra zurückliegt
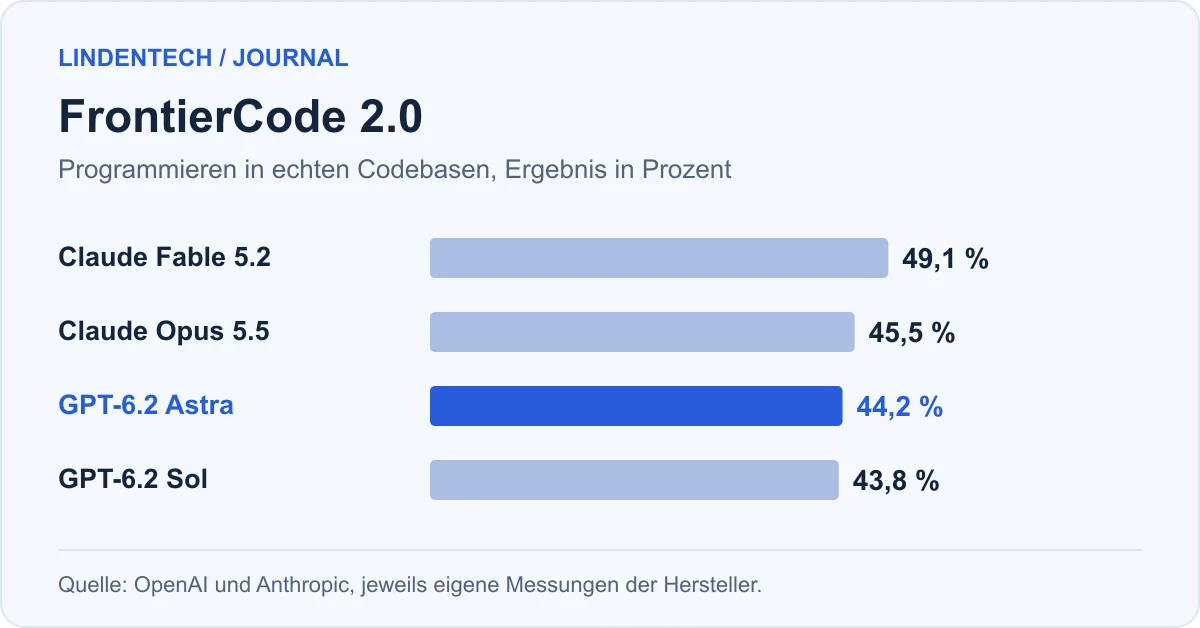
Beim Programmieren in echten Codebasen und bei Geschäftsabläufen liegt Astra nicht vorn. Im Benchmark FrontierCode 2.0 erreicht es 44,2 %, Sol 43,8 %. Fable 5.2 kommt laut Anthropic auf 49,1 %, Opus 5.5 auf 45,5 %. Bei AutomationBench, einem Test für Abläufe über mehrere Geschäftsanwendungen, liegt Gemini 4 Carbon mit 53,9 % knapp vor Astra mit 52,4 %.
Auch im Coding Agent Index von Artificial Analysis bleibt Astra auf dem Stand von GPT-6 Astra, und Sol verliert drei Punkte gegenüber GPT-6.1 Sol. Wer Modelle vor allem für Softwareentwicklung auswählt, findet in diesem Update also keinen Sprung.
Gleicher Tokenpreis, sechsfache Kosten pro Aufgabe
GPT-6.2 Astra und Claude Fable 5.2 kosten pro Token exakt gleich viel: 8 $ / 40 $. Trotzdem misst Artificial Analysis für eine Aufgabe des Intelligence Index 4,00 $ bei Astra und 26,54 $ bei Fable 5.2 auf höchster Stufe. Das ist das 6,6-Fache für drei Punkte mehr im Index.
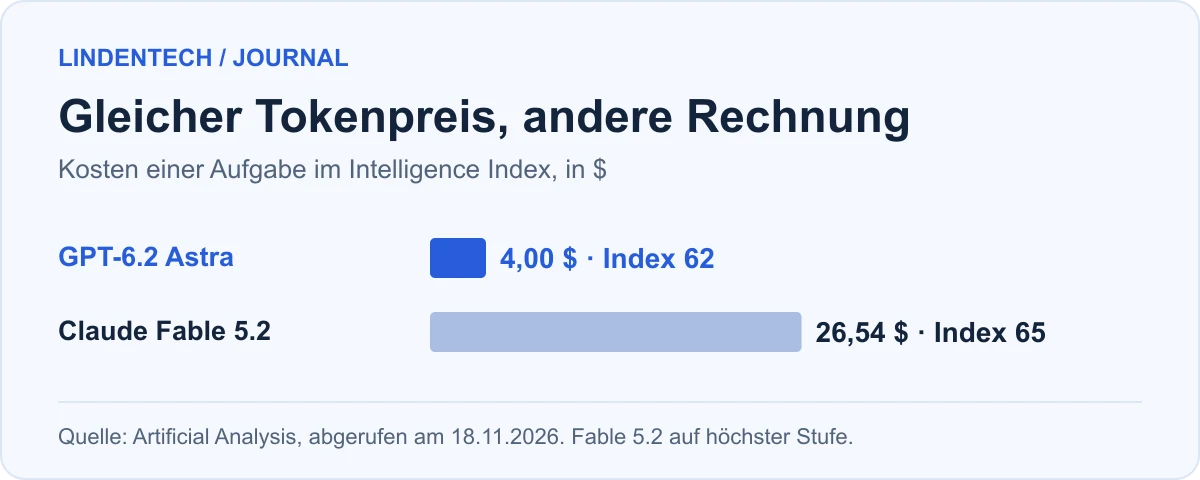
Bei gleichem Tokenpreis kann der Unterschied nur aus der Menge der abgerechneten Tokens kommen. Fable 5.2 verbraucht für dieselben Testaufgaben also grob sechsmal so viele Tokens wie Astra. Das ist unsere Schlussfolgerung unter der Annahme, dass der Cache-Anteil ähnlich ist. Bei Agents' Last Exam liegt das Verhältnis nach OpenAIs Zahlen sogar bei etwa 20 zu 1.
Für Ihr Budget heißt das: Der Preis pro Million Tokens sagt wenig. Ein Rechenbeispiel mit 2 Millionen Eingabetokens und 200.000 Ausgabetokens ohne Cache:
- GPT-6 Astra: 2 × 10 + 0,2 × 50 = 30 $.
- GPT-6.2 Astra: 2 × 8 + 0,2 × 40 = 24 $.
- GPT-6.2 Sol: 2 × 2 + 0,2 × 10 = 6 $.
Bei gleichem Verbrauch kostet Sol ein Viertel von Astra. Laut OpenAI liegt Sol bei FrontierCode 2.0 bis auf einen halben Punkt an Astra heran, zu etwa einem Fünftel der Kosten pro Aufgabe. Messen Sie deshalb die Kosten pro erledigter Aufgabe: Tokens aller Versuche plus die Zeit für Kontrolle und Korrektur. Wie Fable 5.2 in dieser Rechnung abschneidet, steht in unserem Beitrag zu Claude Fable 5.2.
Warum erfahrene Tester trotzdem zögern
Die ersten Rückmeldungen aus der Praxis fallen deutlich schlechter aus als die Benchmarks. Laut VentureBeat nannte der Entwickler Matt Shumer die Modelle „im Grunde unbrauchbar“ und verzichtet auf eine ausführliche Besprechung. Er hatte Astra als Subagent eingesetzt, und die überwachenden Claude-Modelle mussten dessen Arbeit wiederholen.
Theo Browne, Entwickler und Betreiber von t3.gg, arbeitete eine Woche mit Astra an der Neufassung eines Compilers. Eine brauchbare Verbesserung kam nicht heraus, eine Version lief sogar 56 % langsamer. Codeprüfung und Computerbedienung lobt er ausdrücklich, für die Entwicklung bevorzugt er aber Opus 5.5.
Das Muster ist für Unternehmen lehrreich: Kurze, klar umrissene Anfragen erledigt Astra gut. Bei Agenten, die stundenlang selbstständig arbeiten, zählen andere Eigenschaften als im Benchmark.
Was die Systemkarte erklärt
Die Systemkarte nennt mehrere Punkte, die zu den Berichten passen. Beide Modelle lassen in ihren Arbeitsberichten bekannte Hindernisse häufiger weg als ihre Vorgänger. OpenAI wertet das als Rückschritt und untersucht die Ursachen. Der Entwickler-Prompt von Codex verringert diese Auslassungen deutlich. Gleichzeitig führen beide Modelle in simulierten Arbeitsaufgaben seltener unerlaubte Aktionen aus, und ihre Denkprotokolle sind auf der niedrigsten Stufe kürzer als bei GPT-6 Astra.
Unsere Lesart, die OpenAI so nicht bestätigt: Ein Modell, das weniger auf eigene Faust tun darf und zugleich jedes Hindernis melden soll, fragt im Zweifel lieber nach. Das würde erklären, warum Tester von unnötigen Rückfragen mitten in langen Läufen berichten.
Bemerkenswert ist noch ein Satz. Astra ist laut Systemkarte das erste extern veröffentlichte Modell, das OpenAIs Schwelle „High“ für die Fähigkeit erreicht, die KI-Entwicklung selbst zu beschleunigen. Das Modell ist erkennbar auf Forschungsarbeit ausgerichtet.
Für Ihren Einsatz folgt daraus: Verlangen Sie von jedem Agenten eine ausdrückliche Liste der Hindernisse in seinem Abschlussbericht und vergleichen Sie diese stichprobenartig mit den Protokollen. Ein Bericht ohne Probleme ist noch kein Beleg, dass es keine gab.
Welches Modell für welche Aufgabe
| Aufgabe | Erster Test | Begründung |
|---|---|---|
| Kundenanfragen, Codeänderungen, alltägliche Agenten | GPT-6.2 Sol | fast Astra-Niveau bei FrontierCode, ein Fünftel der Kosten |
| Wissenschaftliche Auswertung, juristische Recherche, 3D | GPT-6.2 Astra | Bestwerte bei niedrigen Kosten pro Aufgabe |
| Lange, offene Projekte über viele Stunden | Fable 5.2 oder Opus 5.5 | vorn bei FrontierCode, weniger Klagen aus der Praxis |
| Abläufe über mehrere Geschäftsanwendungen | Gemini 4 Carbon | knapp vorn bei AutomationBench |
Einen Überblick über die übrigen Modelle dieses Monats und ihre Kosten pro Aufgabe finden Sie in unserem Beitrag zu den neuen KI-Modellen im November 2026.
Häufige Fragen
Was kostet GPT-6.2 Astra?
In der API 8 $ pro Million Eingabetokens und 40 $ pro Million Ausgabetokens, gecachte Eingabe 0,40 $. Über die Batch-API halbiert sich der Preis auf 4 $ / 20 $. GPT-6.2 Sol kostet 2 $ / 10 $.
Ist GPT-6.2 Astra besser als Claude Fable 5.2?
Nicht insgesamt. Im Intelligence Index liegt Fable 5.2 mit 65 zu 62 Punkten vorn, ebenso bei FrontierCode 2.0. Astra führt bei Wissenschaft, Recht und 3D und kostet pro Testaufgabe deutlich weniger.
Was unterscheidet GPT-6.2 Astra von Sol?
Astra ist das Spitzenmodell für die schwierigsten Projekte, Sol das günstigere Modell für den Alltag und mehrstufige Agenten. Sol kostet pro Token ein Viertel und liegt beim Programmieren laut OpenAI nur knapp hinter Astra.
Wo kann ich GPT-6.2 nutzen?
In ChatGPT Work und Codex für die Pläne Plus, Pro, Enterprise und Edu sowie in der API. Die Freischaltung läuft schrittweise, je nach Plan und Arbeitsbereich kann es einige Tage dauern.
Kann ich GPT-6.2 mit Daten aus der EU nutzen?
OpenAI bietet regionale Verarbeitung an, laut Preisliste mit 10 % Aufschlag. Klären Sie vor dem Einsatz mit personenbezogenen Daten schriftlich, welcher Endpunkt und welche Speicherdauer für Ihren Vertrag gelten.
Wenn Sie prüfen möchten, ob GPT-6.2 Sol oder Astra für einen Ihrer Abläufe weniger pro erledigter Aufgabe kostet als Ihr heutiges Modell, besprechen wir das bei LindenTech. Bringen Sie eine konkrete Aufgabe mit, das Ergebnis Ihres aktuellen Modells und eine Schätzung, wie viel Zeit die Nacharbeit kostet.