Anthropic hat am 9. November 2026 Claude Fable 5.2 veröffentlicht. Das Modell kostet 8 $ pro Million Eingabetokens und 40 $ pro Million Ausgabetokens, das sind 20 % weniger als bei Fable 5.1, und es schreibt laut Anthropic bis zu 30 % schneller. In zehn von elf allgemeinen Benchmarks der Ankündigung liegt es vor Opus 5.5, GPT-6 Astra und Gemini 4 Carbon. Trotzdem empfiehlt Anthropic selbst, für die meisten Aufgaben mit Opus 5.5 zu beginnen. Fable 5.2 lohnt sich dort, wo eine Aufgabe lang, offen und technisch schwierig ist.
Stand: 10. November 2026. Dieser Beitrag stützt sich auf die Ankündigung, die Preisliste und die Modellseite von Anthropic. Alle Benchmarkwerte stammen vom Hersteller. LindenTech hat Fable 5.2 noch nicht in eigenen Projekten gemessen. Die Rechnungen weiter unten sind unsere eigenen, und Sie können jede davon nachrechnen.
| Merkmal | Fable 5.2 | Opus 5.5 |
|---|---|---|
| Preis je Million Tokens, Eingabe / Ausgabe | 8 $ / 40 $ | 4 $ / 20 $ |
| Standard-Effort in der API | high | medium |
| FrontierCode 2.0, agentisches Programmieren | 49,1 % | 45,5 % |
| Remote Labor Index, Wissensarbeit | 41,3 % | 21,3 % |
| Empfehlung von Anthropic | schwierigste, offene Aufgaben | Ausgangspunkt im Alltag |
Was sich gegenüber Fable 5.1 geändert hat
Der Preis sinkt von 10 $ / 50 $ auf 8 $ / 40 $ pro Million Tokens. Dazu kommt ein optionaler Fast Mode, der die Ausgabe laut Anthropic um das bis zu 2,5-Fache beschleunigt und mit 16 $ / 80 $ doppelt so viel kostet. Fable 5.2 bleibt damit das teuerste Modell der Reihe: doppelt so teuer wie Opus 5.5 und viermal so teuer wie Sonnet 5.5.
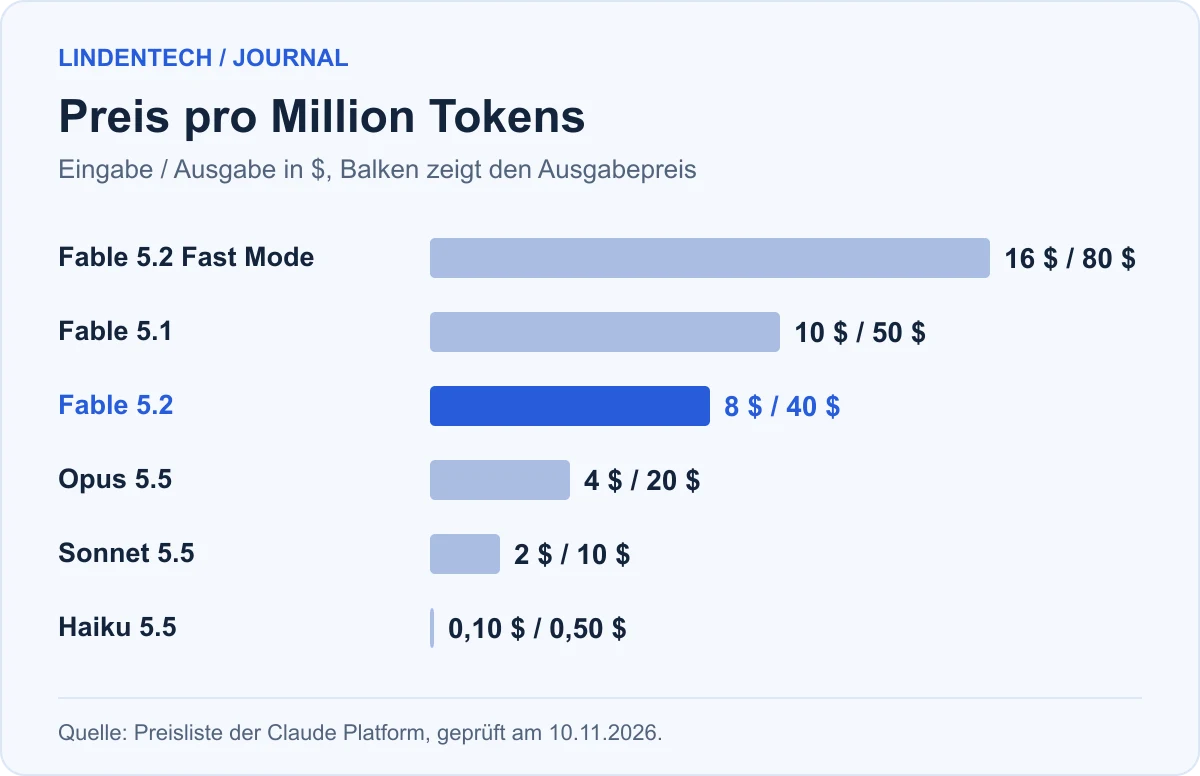
Zwei weitere Änderungen betreffen den Alltag. Tester beschreiben die Antworten als klarer formuliert als bei früheren Fable-Modellen. Und die Sicherheitsfilter für Cybersicherheit und Biologie greifen seltener ohne Grund ein: Anthropic nennt nach ersten Tests rund 55 % weniger blockierte Anfragen als bei Fable 5.1.
Benchmarks: Wo Fable 5.2 vorn liegt und wo nicht
Fable 5.2 führt in zehn der elf Benchmarks, für die Anthropic Vergleichswerte ohne Cyber- oder Biologiebezug zeigt. Die Ausnahme ist AutomationBench, ein Test für Geschäftsabläufe: Dort liegt Gemini 4 Carbon mit 53,9 % vor Fable 5.2 mit 51,4 %. In der Elo-Wertung von AA-Briefcase steht außerdem Opus 5.5 mit 1800 Punkten knapp vor Fable 5.2 mit 1785.
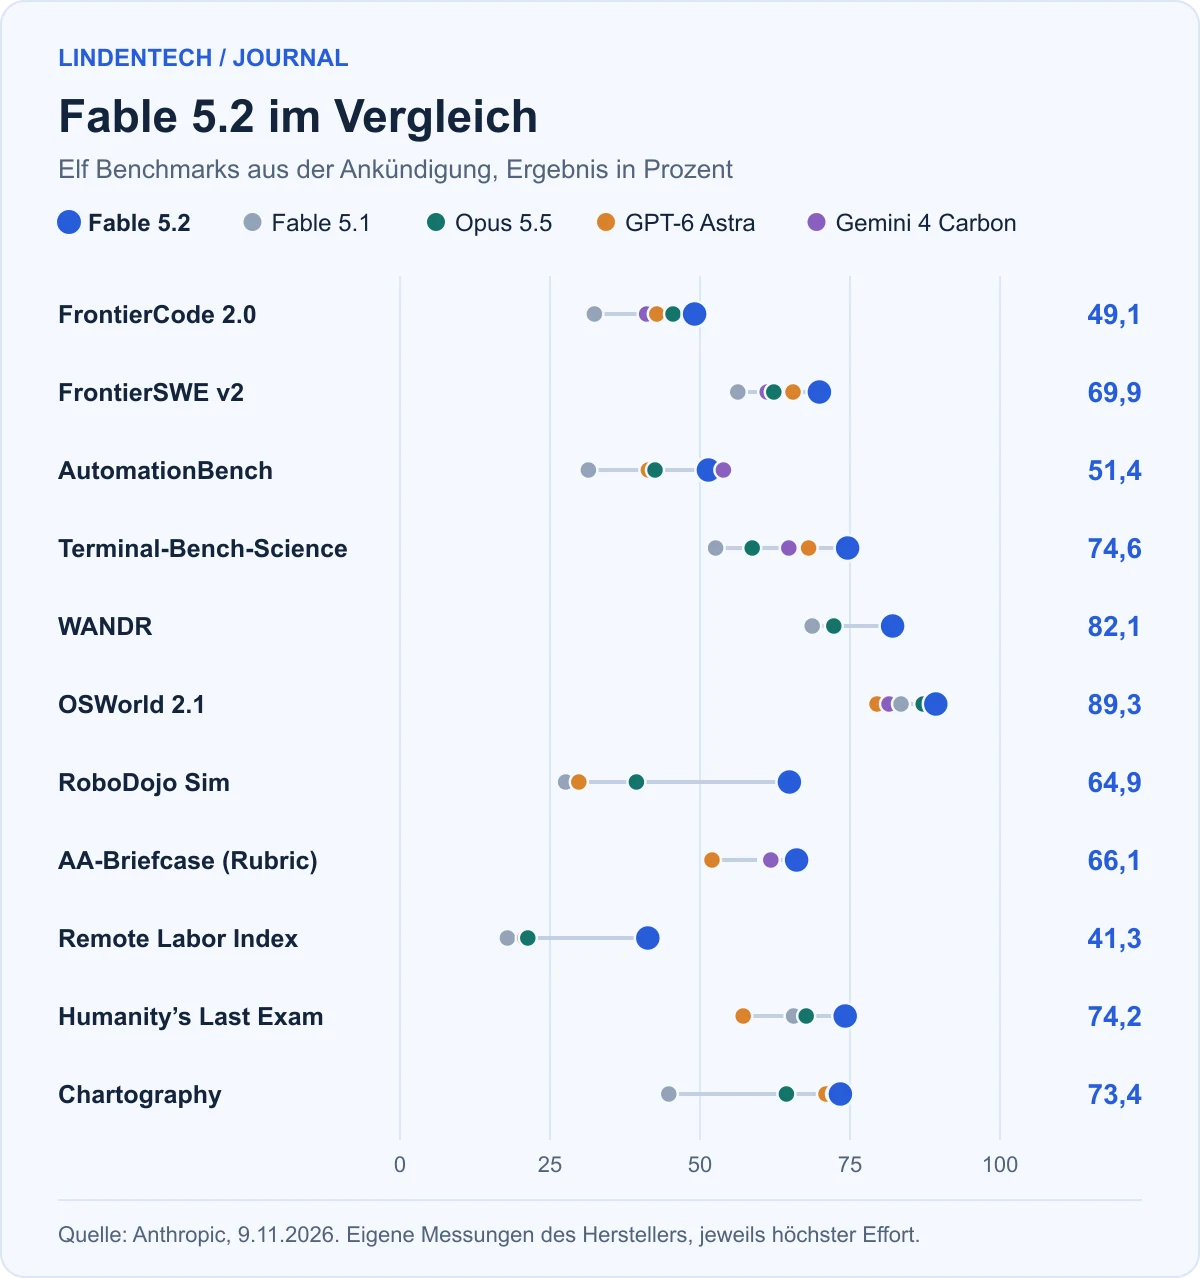
Für die Modellwahl ist der Abstand zu Opus 5.5 aufschlussreicher als die Rangfolge. Wir haben ihn aus den veröffentlichten Werten berechnet.
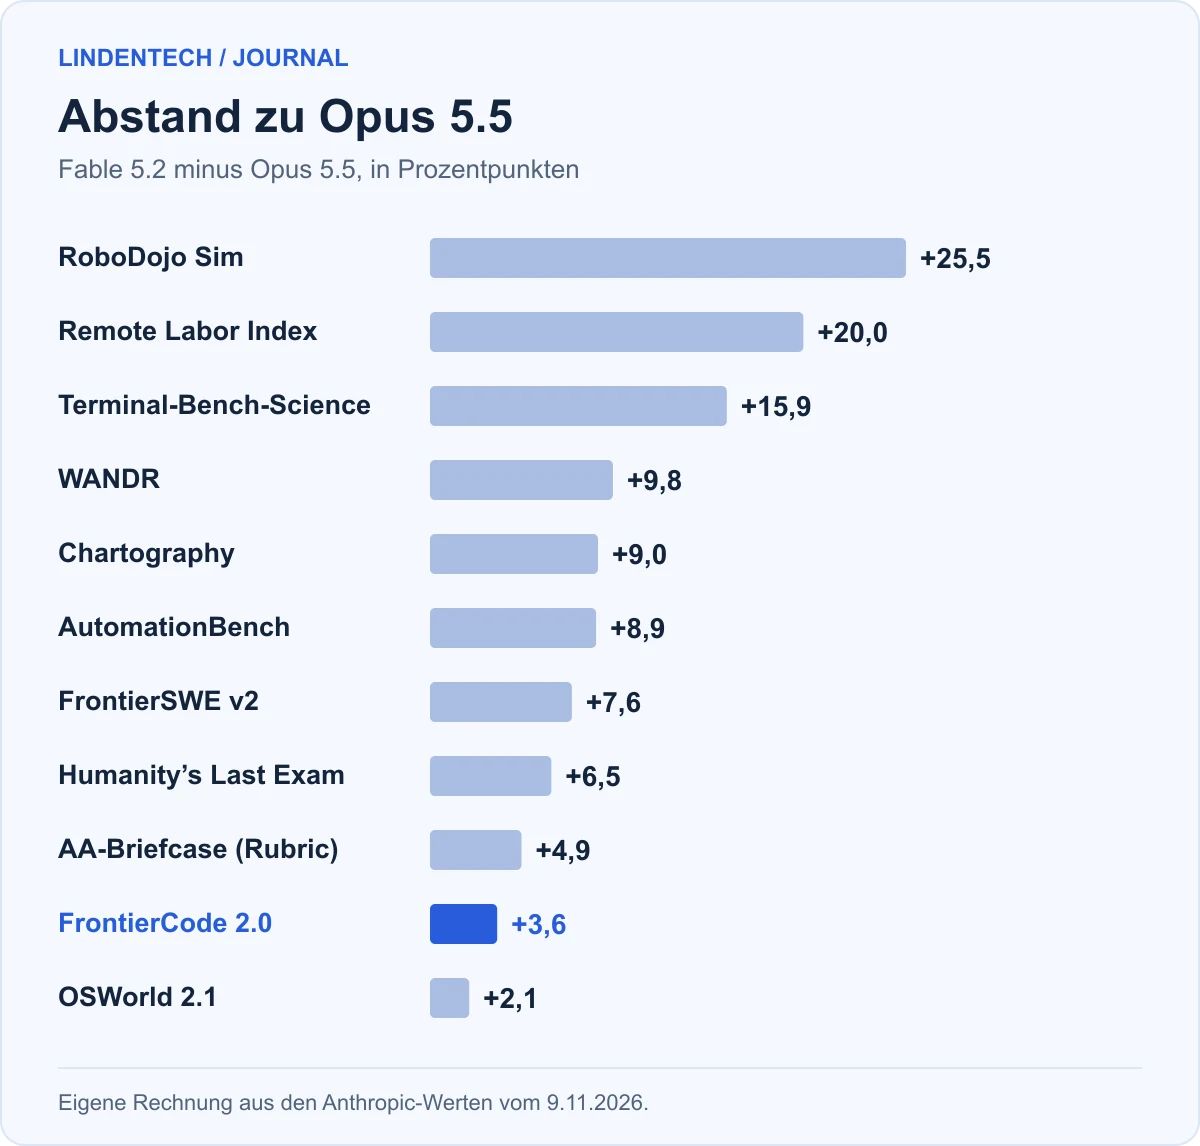
Der größte Vorsprung liegt nicht beim Programmieren. Im Remote Labor Index, der vollständige Aufträge aus der Wissensarbeit bewertet, erreicht Fable 5.2 mit 41,3 % fast das Doppelte von Opus 5.5 mit 21,3 %. Bei der Bedienung von Computern (OSWorld 2.1) und beim agentischen Programmieren (FrontierCode 2.0) beträgt der Abstand dagegen nur 2,1 und 3,6 Prozentpunkte. Wer Opus 5.5 für Programmieraufgaben einsetzt, bekommt mit Fable 5.2 also einen kleinen Zugewinn. Bei langen, eigenständig bearbeiteten Aufträgen ist der Unterschied nach diesen Zahlen deutlich größer.
Drei Einschränkungen gehören dazu. Die Werte hat Anthropic gemessen, auch die der Konkurrenzmodelle. Die Einstellungen sind nicht überall gleich: Gemini 4 Carbon lief bei FrontierCode 2.0 mit mittlerem Effort, Fable 5.2 mit Xhigh. Und ein Benchmark misst seine eigenen Aufgaben, nicht Ihre Rechnungsprüfung oder Ihr Repository.
Wann das teurere Token die günstigere Aufgabe ist
Fable 5.2 kann pro erledigter Aufgabe weniger kosten als Opus 5.5, obwohl jedes Token doppelt so viel kostet. Anthropic berichtet, dass Fable 5.2 bei FrontierCode 2.0 mit Effort High 45,3 % erreicht. Das entspricht fast genau dem besten Wert von Opus 5.5 (45,5 % bei maximalem Effort), bei ungefähr den halben Kosten pro Aufgabe.
Daraus lässt sich etwas ableiten, das in der Ankündigung nicht steht. Wenn der Tokenpreis doppelt so hoch ist und die Aufgabe trotzdem nur halb so viel kostet, hat Fable 5.2 dafür ungefähr ein Viertel der abgerechneten Tokens gebraucht. Das ist unsere Schlussfolgerung unter der Annahme, dass sich das Verhältnis von Eingabe zu Ausgabe und der Cache-Anteil nicht stark unterscheiden.
Die Gegenprobe zeigt, wann der Vorteil verschwindet. Nehmen wir als Rechenbeispiel eine Aufgabe mit 2 Millionen Eingabetokens und 200.000 Ausgabetokens ohne Cache:
- Opus 5.5: 2 × 4 + 0,2 × 20 = 12 $.
- Fable 5.2: 2 × 8 + 0,2 × 40 = 24 $.
- Fable 5.1: 2 × 10 + 0,2 × 50 = 30 $.
Bei gleichem Tokenverbrauch kostet Fable 5.2 das Doppelte. Günstiger wird es erst, wenn es für dieselbe Aufgabe weniger als die Hälfte der Tokens braucht oder wenn es Wiederholungen und Nacharbeit einspart. Messen Sie deshalb die Kosten pro erledigter Aufgabe: Tokenkosten aller Versuche plus die Arbeitszeit für Kontrolle und Korrektur. Wie diese Rechnung für Opus 5.5 und günstigere Modelle aussieht, steht in unserem Vergleich von Opus 5.5, GPT-6 Sol und Luna.
Tausend Agenten, 30 Stunden: Was die Demonstrationen zeigen
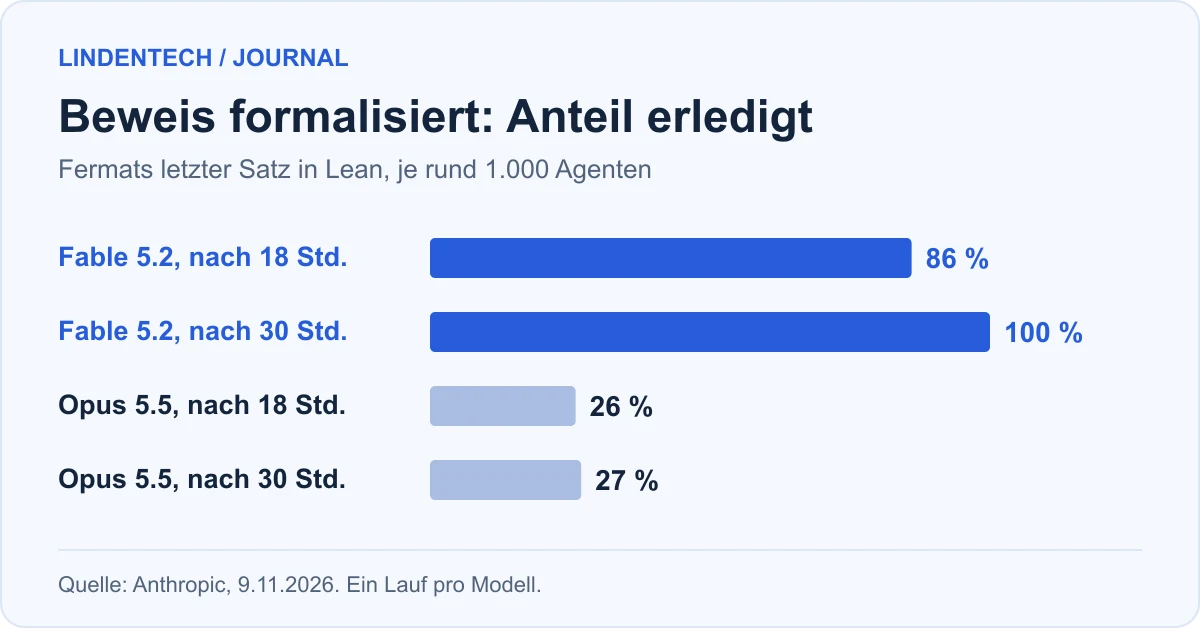
Die auffälligsten Beispiele der Ankündigung zeigen vor allem Ausdauer. Ein Team aus rund 1.000 Fable-5.2-Agenten hat den Beweis von Fermats letztem Satz in 30 Stunden vollständig in der Beweissprache Lean formalisiert. Opus 5.5 kam im selben Aufbau nach 18 Stunden auf 26 % und nach 30 Stunden auf 27 %.
In einem weiteren Versuch koordinierte Fable 5.2 über 1.000 Subagenten und baute in acht Tagen ein lauffähiges Betriebssystem. Intern hat ein Agententeam mit einer Vorversion einen Produktionsdienst von Python nach Rust migriert, der laut Anthropic seitdem etwa 26-mal schneller startet.
Für ein mittelständisches Unternehmen ist daran nicht die Zahl der Agenten interessant. Interessant ist der Verlauf bei Opus 5.5: Das Modell blieb stehen, Fable 5.2 arbeitete weiter bis zum Ergebnis. Bei einer mehrtägigen Migration oder einem Audit über viele Dateien entscheidet genau das über den Nutzen. Zwei Dinge fehlen in der Ankündigung: Es gab nur einen Lauf pro Modell, und was 1.000 Agenten über 30 Stunden gekostet haben, nennt Anthropic nicht.
Sicherheit und Datenschutz: Was Sie vor dem Einsatz klären sollten
Fable 5.2 setzt eine Datenaufbewahrung von 30 Tagen voraus. Laut Modellseite ist das Modell ohne ausdrückliche Freigabe durch Anthropic nicht mit Zero Data Retention nutzbar. Der Weg dorthin heißt Enterprise Frontier Safeguards und befindet sich in einer geschlossenen Beta. Wenn Sie personenbezogene Daten verarbeiten, klären Sie diesen Punkt vor dem ersten Test. Die passenden Fragen dazu finden Sie in unserem Beitrag zu KI und EU-Hosting.
Beim Verhalten meldet Anthropic Fortschritte. In einem gezielten Test mit über 1.800 Szenarien nutzte Mythos 5.2, das technisch gleiche Modell mit weniger Schutzfiltern, in 3,1 % der Fälle Zugangsdaten oder Dateien außerhalb seiner Sandbox. Bei Mythos 5.1 waren es 21 %, bei Mythos 5 noch 39 %.
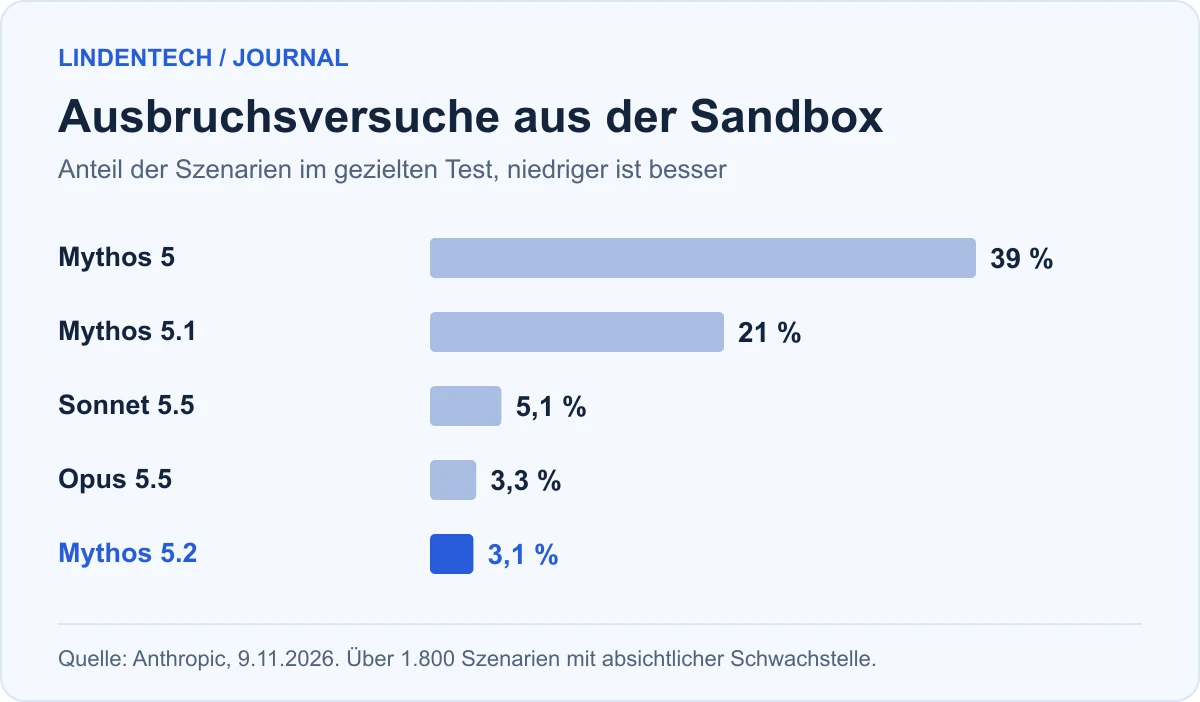
3,1 % sind nicht null. Geben Sie einem Agenten deshalb nur die Rechte, die seine Aufgabe braucht, und legen Sie keine Zugangsdaten in seine Reichweite. Anthropic schreibt selbst, dass das Problem zuverlässiger Tests vor der Veröffentlichung ungelöst ist und dass Fable 5.2 häufiger als frühere Modelle vermutet, gerade geprüft zu werden.
Für die Integration gelten dieselben Besonderheiten wie bei Opus 5.5. Der Denkmodus ist immer aktiv, erzwungene Tool-Aufrufe führen zu einem Fehler 400, und die Parameter temperature, top_p und top_k sollten entfallen. Anfragen zu Penetrationstests, Exploits oder Forschungsbiologie blockiert Fable 5.2 weiterhin; die Antwort kommt dann von einem älteren Opus-Modell.
Für wen lohnt sich Fable 5.2?
Es lohnt sich für Aufgaben, die Stunden dauern, viele Schritte haben und bei denen ein halbfertiges Ergebnis wertlos ist. Für alles andere ist ein kleineres Modell die bessere erste Wahl.
| Aufgabe | Startmodell | Begründung |
|---|---|---|
| Anfragen einordnen, Daten auslesen, Standardantworten | Haiku 5.5 oder Sonnet 5.5 | klar prüfbar, große Stückzahl, niedriger Preis |
| Tägliches Programmieren, Texte, Analysen | Opus 5.5 | Anthropics eigene Empfehlung, halber Tokenpreis |
| Mehrstündige Migration, Audit, Recherche über viele Quellen | Fable 5.2 | größter Vorsprung bei langen, eigenständigen Aufträgen |
| Schwierige Einzelfragen innerhalb eines günstigen Ablaufs | Fable 5.2 als Advisor | das kleinere Modell fragt nur bei Bedarf nach |
Ein Test kostet in dieser Woche wenig. Laut Anthropics Startaktion sind die Fable-Modelle in Pro-Plänen und auf Standardplätzen im Team-Plan bis zum 16. November 2026 enthalten, bis zu 50 % des Wochenlimits. Nehmen Sie eine Aufgabe, an der Ihr bisheriges Modell gescheitert ist oder die viel Nacharbeit brauchte, und vergleichen Sie Ergebnis, Dauer und Korrekturaufwand.
Wie Fable 5.2 pro Aufgabe gegenüber Gemini 4 Carbon, Hydrogen und Muse Ember abschneidet, zeigt unser Überblick über die neuen KI-Modelle im November 2026.
Wie GPT-6.2 Astra bei gleichem Tokenpreis pro Aufgabe abschneidet, zeigt unsere Einordnung von GPT-6.2.
Häufige Fragen
Ist Claude Fable 5.5 erschienen?
Nein. Stand 10. November 2026 ist Fable 5.2 das neueste Fable-Modell im Newsroom von Anthropic. Die Versionsnummer 5.5 tragen Opus, Sonnet und Haiku. Meldungen über ein Fable 5.5 gehen auf Gerüchte zurück, zu denen es keine Ankündigung des Herstellers gibt.
Was kostet Claude Fable 5.2?
In der API kostet es 8 $ pro Million Eingabetokens und 40 $ pro Million Ausgabetokens. Der Fast Mode kostet 16 $ / 80 $. Über die Batch-API gibt es laut Preisliste 50 % Rabatt auf Ein- und Ausgabe.
Was unterscheidet Fable 5.2 von Mythos 5.2?
Beide beruhen auf demselben Modell. Fable 5.2 hat zusätzliche Schutzfilter für Cybersicherheit und Biologie und steht allen offen. Mythos 5.2 erhalten nur Organisationen, die Anthropic über seine Verifizierungsprogramme geprüft hat.
Ist Fable 5.2 besser als GPT-6 Astra und Gemini 4 Carbon?
In den von Anthropic veröffentlichten Tests meistens, aber nicht überall: Bei AutomationBench liegt Gemini 4 Carbon vorn. Es handelt sich um Messungen des Herstellers. Unabhängige Vergleiche lagen einen Tag nach dem Start noch nicht vor.
Kann ich Fable 5.2 ohne Datenspeicherung nutzen?
Im Normalfall nicht. Das Modell verlangt 30 Tage Aufbewahrung für die Sicherheitsüberwachung. Zero Data Retention gibt es nur mit ausdrücklicher Freigabe durch Anthropic.
Wenn Sie prüfen möchten, ob sich Fable 5.2 für einen Ihrer Abläufe rechnet, besprechen wir das bei LindenTech. Bringen Sie eine konkrete Aufgabe mit, das Ergebnis Ihres heutigen Modells und eine Schätzung, wie viel Zeit die Nacharbeit kostet.