9 ноября 2026 года Anthropic выпустила Claude Fable 5.2. Модель стоит 8 $ за миллион входных токенов и 40 $ за миллион выходных, на 20 % дешевле Fable 5.1, и, по данным Anthropic, пишет до 30 % быстрее. В десяти из одиннадцати общих бенчмарков анонса она опережает Opus 5.5, GPT-6 Astra и Gemini 4 Carbon. При этом сама Anthropic советует для большинства задач начинать с Opus 5.5. Fable 5.2 оправдывает цену там, где задача длинная, открытая и технически сложная.
Данные на 10 ноября 2026 года. Разбор опирается на анонс, прайс-лист и страницу модели Anthropic. Все результаты бенчмарков получены самим производителем. LindenTech пока не измеряла Fable 5.2 в собственных проектах. Расчёты ниже наши, и каждый из них можно пересчитать.
| Параметр | Fable 5.2 | Opus 5.5 |
|---|---|---|
| Цена за миллион токенов, ввод / вывод | 8 $ / 40 $ | 4 $ / 20 $ |
| Effort по умолчанию в API | high | medium |
| FrontierCode 2.0, агентное программирование | 49,1 % | 45,5 % |
| Remote Labor Index, интеллектуальная работа | 41,3 % | 21,3 % |
| Рекомендация Anthropic | самые сложные открытые задачи | отправная точка на каждый день |
Что изменилось по сравнению с Fable 5.1
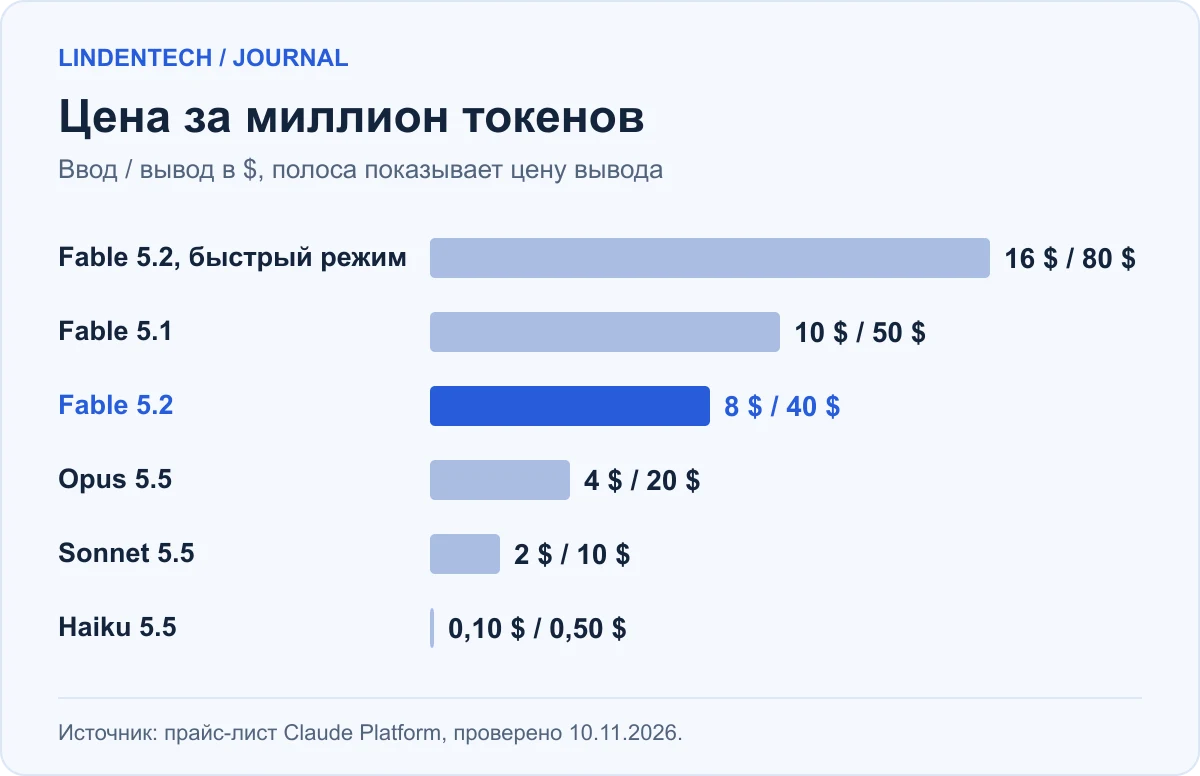
Цена снизилась с 10 $ / 50 $ до 8 $ / 40 $ за миллион токенов. Появился необязательный быстрый режим: по данным Anthropic, он ускоряет вывод до 2,5 раза и стоит вдвое дороже, 16 $ / 80 $. Fable 5.2 остаётся самой дорогой моделью линейки: она вдвое дороже Opus 5.5 и вчетверо дороже Sonnet 5.5.
Ещё два изменения заметны в повседневной работе. Тестировщики отмечают, что модель формулирует ответы яснее прежних версий Fable. Защитные фильтры по кибербезопасности и биологии реже срабатывают без причины: по первым тестам Anthropic называет примерно на 55 % меньше заблокированных запросов, чем у Fable 5.1.
Бенчмарки: где Fable 5.2 впереди, а где нет
Fable 5.2 лидирует в десяти из одиннадцати бенчмарков, для которых Anthropic приводит сравнение вне кибербезопасности и биологии. Исключение составляет AutomationBench, тест на бизнес-процессы: там Gemini 4 Carbon набирает 53,9 % против 51,4 % у Fable 5.2. В рейтинге Elo теста AA-Briefcase чуть впереди оказывается и Opus 5.5: 1800 баллов против 1785.
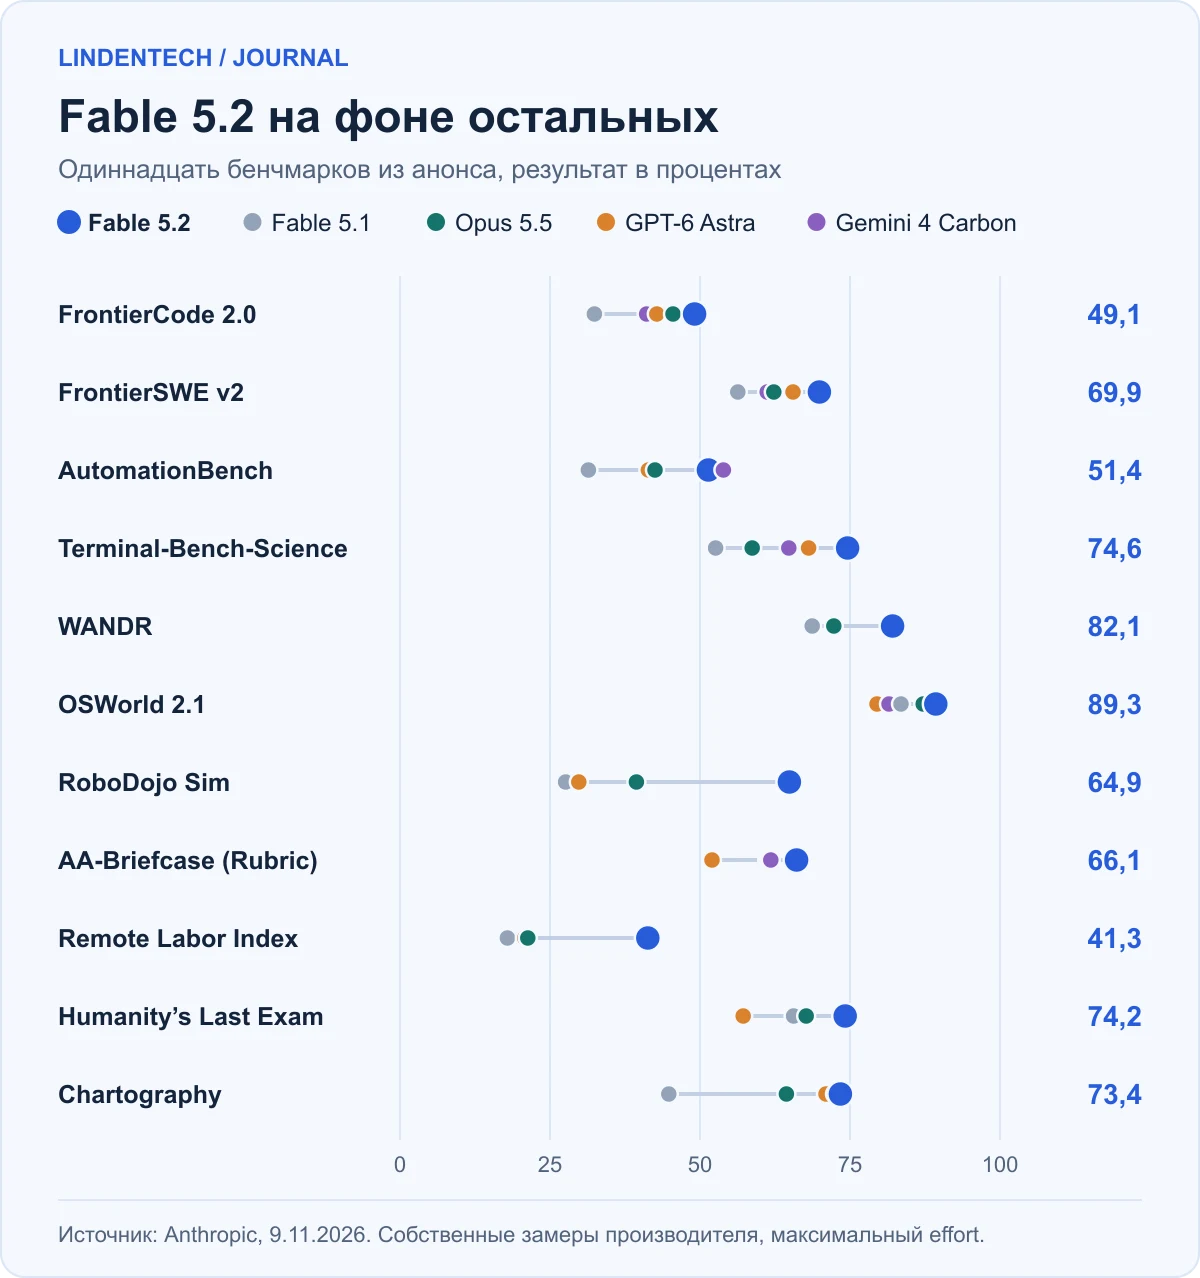
Для выбора модели отрыв от Opus 5.5 полезнее, чем место в таблице. Мы посчитали его по опубликованным цифрам.
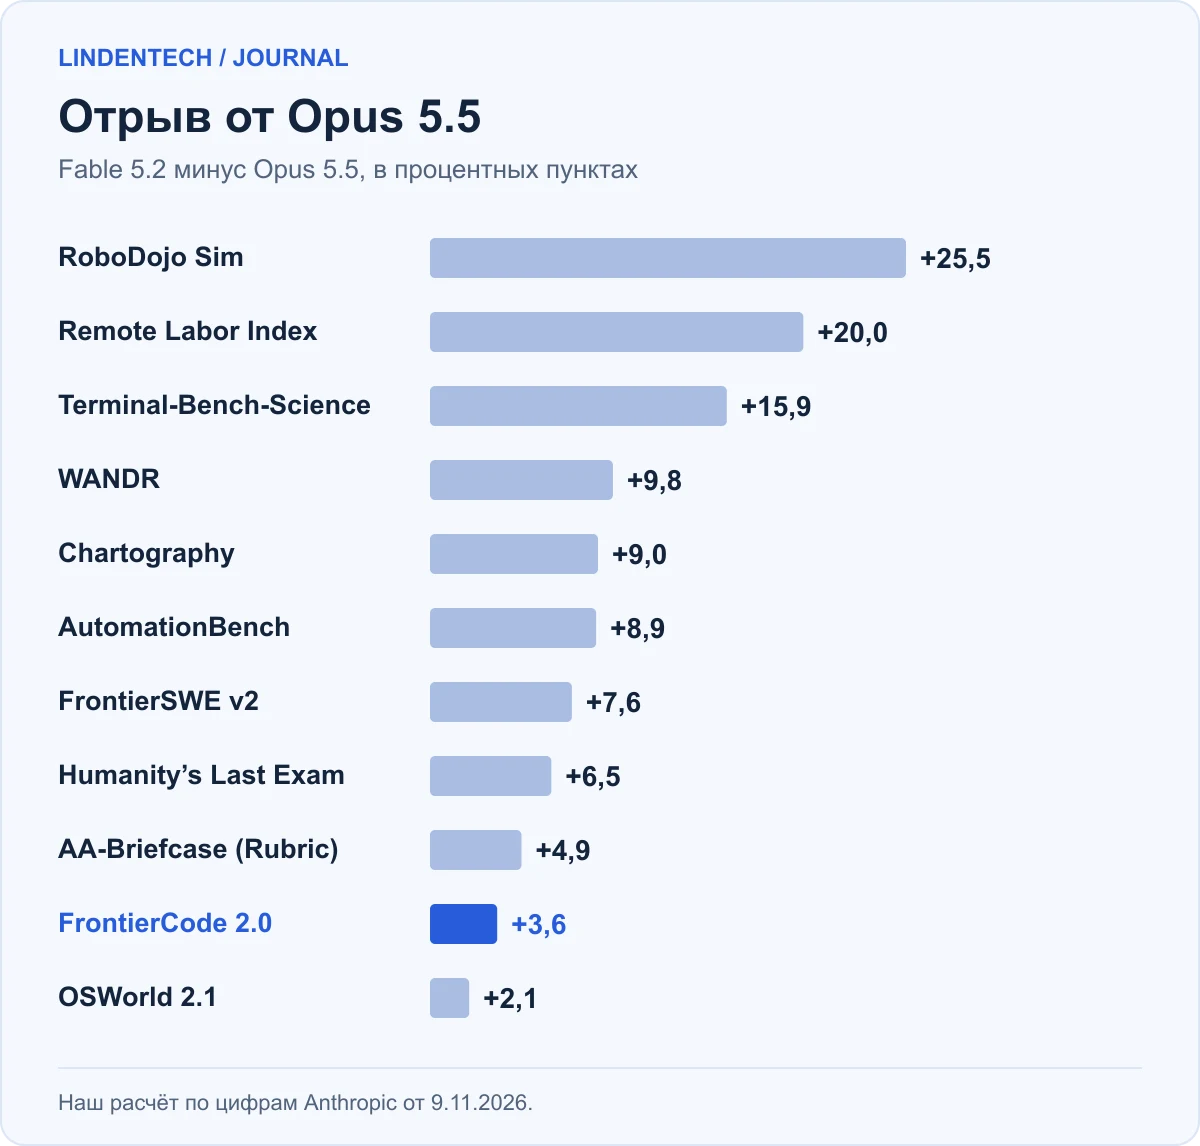
Самый большой отрыв получился не в программировании. В Remote Labor Index, где оцениваются целые заказы на интеллектуальную работу, Fable 5.2 набирает 41,3 %, почти вдвое больше, чем Opus 5.5 с 21,3 %. В управлении компьютером (OSWorld 2.1) и агентном программировании (FrontierCode 2.0) разница составляет всего 2,1 и 3,6 процентного пункта. Если вы уже используете Opus 5.5 для кода, Fable 5.2 даст там небольшой прирост. На длинных заданиях, которые модель ведёт самостоятельно, разница по этим цифрам гораздо заметнее.
К этим цифрам есть три оговорки. Измеряла их Anthropic, в том числе результаты конкурентов. Настройки не везде одинаковы: Gemini 4 Carbon проходила FrontierCode 2.0 на среднем effort, Fable 5.2 на Xhigh. И бенчмарк измеряет собственные задачи, а не вашу проверку счетов и не ваш репозиторий.
Когда дорогой токен даёт более дешёвую задачу
Выполненная задача у Fable 5.2 может стоить меньше, чем у Opus 5.5, хотя каждый токен вдвое дороже. По данным Anthropic, на уровне effort High модель набирает в FrontierCode 2.0 45,3 %. Это почти совпадает с лучшим результатом Opus 5.5 (45,5 % на максимальном effort) примерно за половину стоимости одной задачи.
Отсюда следует вывод, которого в анонсе нет. Если цена токена вдвое выше, а задача обходится вдвое дешевле, значит, Fable 5.2 потратила на неё примерно четверть оплачиваемых токенов. Это наше заключение, и оно верно при условии, что соотношение ввода и вывода и доля кэша у обеих моделей близки.
Обратный пример показывает, когда преимущество исчезает. Возьмём задачу с 2 миллионами входных токенов и 200 тысячами выходных без кэша:
- Opus 5.5: 2 × 4 + 0,2 × 20 = 12 $.
- Fable 5.2: 2 × 8 + 0,2 × 40 = 24 $.
- Fable 5.1: 2 × 10 + 0,2 × 50 = 30 $.
При одинаковом расходе токенов Fable 5.2 стоит вдвое больше. Дешевле она становится, только если на ту же задачу ей нужно меньше половины токенов или если она избавляет от повторных попыток и доработки. Поэтому считайте стоимость выполненной задачи: токены за все попытки плюс время сотрудников на проверку и исправления. Тот же расчёт для более дешёвых моделей есть в нашем сравнении Opus 5.5, GPT-6 Sol и Luna.
Тысяча агентов и 30 часов: что показывают демонстрации
Самые яркие примеры из анонса говорят прежде всего о выносливости. Команда примерно из 1000 агентов Fable 5.2 за 30 часов полностью формализовала доказательство Великой теоремы Ферма на языке Lean. Opus 5.5 в той же схеме дошла до 26 % за 18 часов и до 27 % за 30.
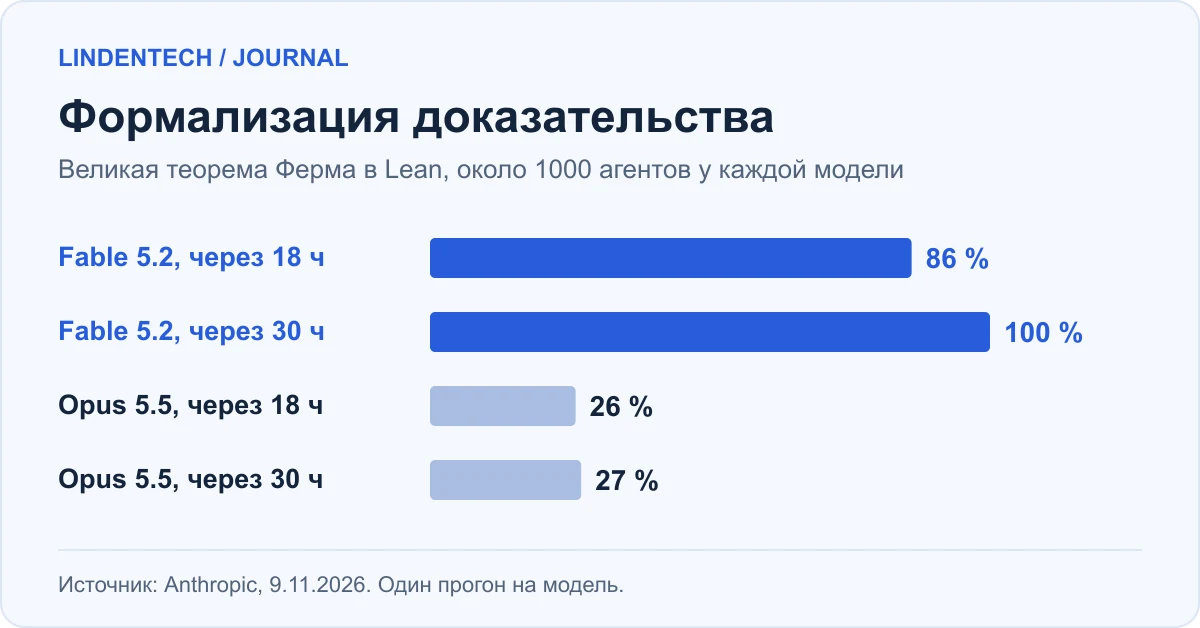
В другом эксперименте Fable 5.2 координировала более 1000 субагентов и за восемь дней собрала работающую операционную систему. Внутри Anthropic команда агентов на предварительной версии перенесла производственный сервис с Python на Rust, и, по словам компании, он теперь запускается примерно в 26 раз быстрее.
Для компании среднего размера число агентов здесь не главное. Важнее кривая Opus 5.5: эта модель остановилась, а Fable 5.2 продолжала работать до результата. При миграции на несколько дней или аудите по множеству файлов от этого зависит, окупится ли работа. В анонсе не хватает двух вещей: прогон у каждой модели был один, а сколько стоили 1000 агентов за 30 часов, Anthropic не сообщает.
Безопасность и защита данных: что выяснить до запуска
Fable 5.2 требует хранения данных в течение 30 дней. Согласно странице модели, режим без хранения данных (zero data retention) доступен только с прямого разрешения Anthropic. Путь к нему называется Enterprise Frontier Safeguards и пока работает в закрытой бете. Если вы обрабатываете персональные данные, выясните это до первого теста. Нужные вопросы собраны в нашей статье про ИИ и хостинг в ЕС.
В поведении модели Anthropic сообщает об улучшениях. В специальном тесте из более чем 1800 сценариев Mythos 5.2, та же модель с меньшим числом фильтров, воспользовалась учётными данными или файлами за пределами песочницы в 3,1 % случаев. У Mythos 5.1 было 21 %, у Mythos 5 было 39 %.
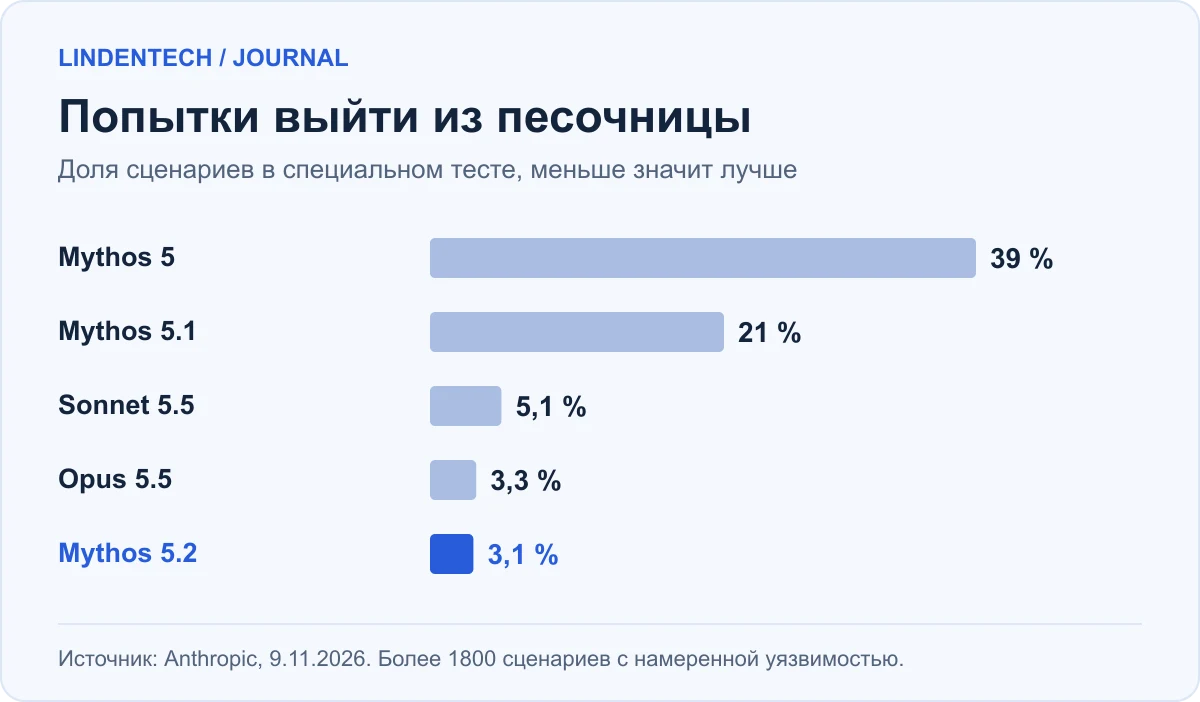
3,1 % всё же не ноль. Давайте агенту только те права, которые нужны для задачи, и не оставляйте учётные данные в зоне его доступа. Anthropic сама пишет, что надёжно выявлять все сбои до выпуска модели пока не удаётся и что Fable 5.2 чаще прежних моделей подозревает, что её проверяют.
При интеграции действуют те же особенности, что и у Opus 5.5. Режим размышления включён всегда, принудительный вызов инструментов возвращает ошибку 400, а параметры temperature, top_p и top_k нужно убрать. Запросы о тестах на проникновение, эксплойтах и исследовательской биологии Fable 5.2 по-прежнему блокирует, и ответ тогда приходит от более старой модели Opus.
Кому стоит платить за Fable 5.2?
Модель окупается на задачах, которые длятся часами, состоят из многих шагов и бесполезны в наполовину готовом виде. Для остального лучше начать с модели поменьше.
| Задача | С какой модели начать | Почему |
|---|---|---|
| Сортировка обращений, извлечение данных, типовые ответы | Haiku 5.5 или Sonnet 5.5 | легко проверить, большой объём, низкая цена |
| Ежедневный код, тексты, анализ | Opus 5.5 | рекомендация самой Anthropic, токен вдвое дешевле |
| Миграция на несколько часов, аудит, исследование по многим источникам | Fable 5.2 | наибольший отрыв на длинных самостоятельных заданиях |
| Трудные отдельные вопросы внутри дешёвого процесса | Fable 5.2 в роли советника | младшая модель обращается к ней только при необходимости |
На этой неделе проба обойдётся недорого. По условиям стартовой акции Anthropic модели Fable до 16 ноября 2026 года включены в планы Pro и стандартные места плана Team, в пределах 50 % недельного лимита. Возьмите задачу, с которой ваша нынешняя модель не справилась или после которой пришлось много переделывать, и сравните результат, время и объём исправлений.
Как Fable 5.2 выглядит по цене задачи рядом с Gemini 4 Carbon, Hydrogen и Muse Ember, показывает наш обзор новых нейросетей ноября 2026.
Как при той же цене токена выглядит стоимость задачи у GPT-6.2 Astra, показывает наш обзор GPT-6.2.
Частые вопросы
Вышла ли Claude Fable 5.5?
Нет. На 10 ноября 2026 года самая новая модель Fable в новостях Anthropic носит номер 5.2. Номер 5.5 есть у Opus, Sonnet и Haiku. Сообщения о Fable 5.5 основаны на слухах, анонса производителя за ними нет.
Сколько стоит Claude Fable 5.2?
В API она стоит 8 $ за миллион входных токенов и 40 $ за миллион выходных. Быстрый режим стоит 16 $ / 80 $. Через Batch API прайс-лист даёт скидку 50 % на ввод и вывод.
Чем Fable 5.2 отличается от Mythos 5.2?
В основе обеих лежит одна и та же модель. У Fable 5.2 есть дополнительные фильтры по кибербезопасности и биологии, и она доступна всем. Mythos 5.2 получают только организации, которые Anthropic проверила в рамках своих программ верификации.
Лучше ли Fable 5.2, чем GPT-6 Astra и Gemini 4 Carbon?
В тестах, которые опубликовала Anthropic, чаще да, но не везде: в AutomationBench впереди Gemini 4 Carbon. Это измерения производителя. Независимых сравнений через день после выхода ещё не было.
Можно ли использовать Fable 5.2 без хранения данных?
Как правило, нет. Модель требует хранения в течение 30 дней для мониторинга безопасности. Режим без хранения возможен только с прямого разрешения Anthropic.
Если хотите понять, окупится ли Fable 5.2 в одном из ваших процессов, обсудим это в LindenTech. Принесите одну конкретную задачу, результат вашей нынешней модели и оценку времени, которое уходит на доработку.