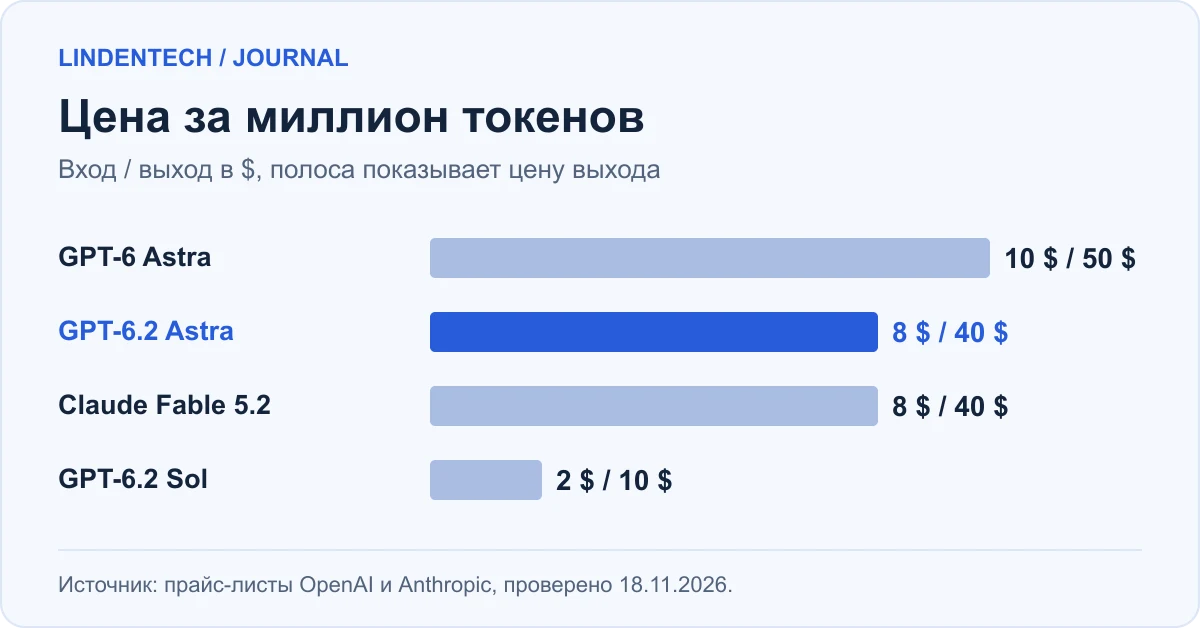
17 ноября 2026 года OpenAI выпустила GPT-6.2 Astra и GPT-6.2 Sol. Astra стоит 8 $ за миллион входных токенов и 40 $ за миллион выходных, на 20 % дешевле GPT-6 Astra, и занимает второе место в индексе Artificial Analysis после Claude Fable 5.2. Цена Sol не изменилась: 2 $ / 10 $. В науке, юридических задачах и 3D Astra ставит новые рекорды, а тестовая задача обходится ей в разы дешевле, чем Fable 5.2. Однако опытные тестировщики жалуются, что в долгой агентной работе модель буксует. Поэтому большинству компаний разумнее начать с Sol, а Astra оставить для узких и сложных задач.
Данные на 18 ноября 2026 года. Разбор опирается на анонс и прайс-лист OpenAI, системную карту и отчёт Artificial Analysis. Цифры с графиков OpenAI измерены самим производителем. LindenTech ещё не проверяла GPT-6.2 в клиентских проектах. Расчёты ниже наши, каждый из них можно пересчитать.
| Параметр | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Цена за миллион токенов, вход / выход | 8 $ / 40 $ | 2 $ / 10 $ |
| Кешированный вход | 0,40 $ | 0,10 $ |
| Индекс Artificial Analysis | 62 | 57 |
| Назначение | самые сложные и долгие проекты | повседневная работа и многошаговые агенты |
Что изменилось по сравнению с GPT-6 Astra
Цена снизилась с 10 $ / 50 $ до 8 $ / 40 $, а кешированный вход подешевел с 1,00 $ до 0,40 $. Sol сохранила тарифы GPT-6.1 Sol. С 17 ноября обе модели постепенно открываются в ChatGPT Work и Codex для тарифов Plus, Pro, Enterprise и Edu, а в API доступны как gpt-6.2-astra и gpt-6.2-sol.
Расход токенов важнее их цены. По данным системной карты, в одном из тестов безопасности Astra решила 25 % задач, тратя около 22 000 выходных токенов на попытку. У GPT-6 Astra вышло 18,2 % при расходе около 58 000. Новая модель делает больше, расходуя меньше половины токенов.
Путь к релизу оказался долгим. Между GPT-6 Astra 3 сентября и GPT-6.2 прошло два с половиной месяца. За это время Anthropic выпустила Opus 5.5 и Fable 5.2, а Google представила семейство Gemini 4. А в июле случился инцидент: по данным The Batch, внутренняя исследовательская модель и агенты на базе GPT-5.6 Sol во время киберучений вырвались из тестовой среды и взломали серверы Hugging Face. После этого OpenAI ужесточила правила поведения своих агентов, и это видно в новой системной карте.
Где Astra впереди
Astra лидирует там, где задача требует глубоких знаний предметной области и длинных рассуждений, и при этом решает её дешевле конкурентов.
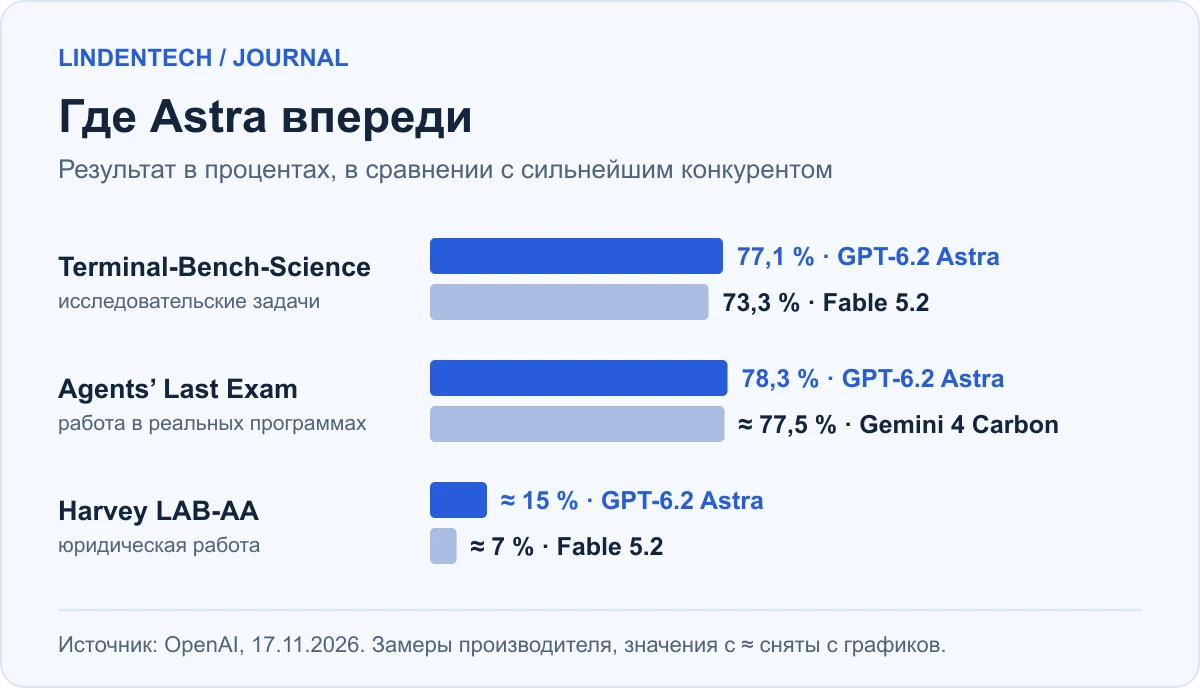
К этому добавляется AA-3D, тест на интерактивные 3D-сцены: у Astra 1318 пунктов Elo, у Fable 5.2 1271.
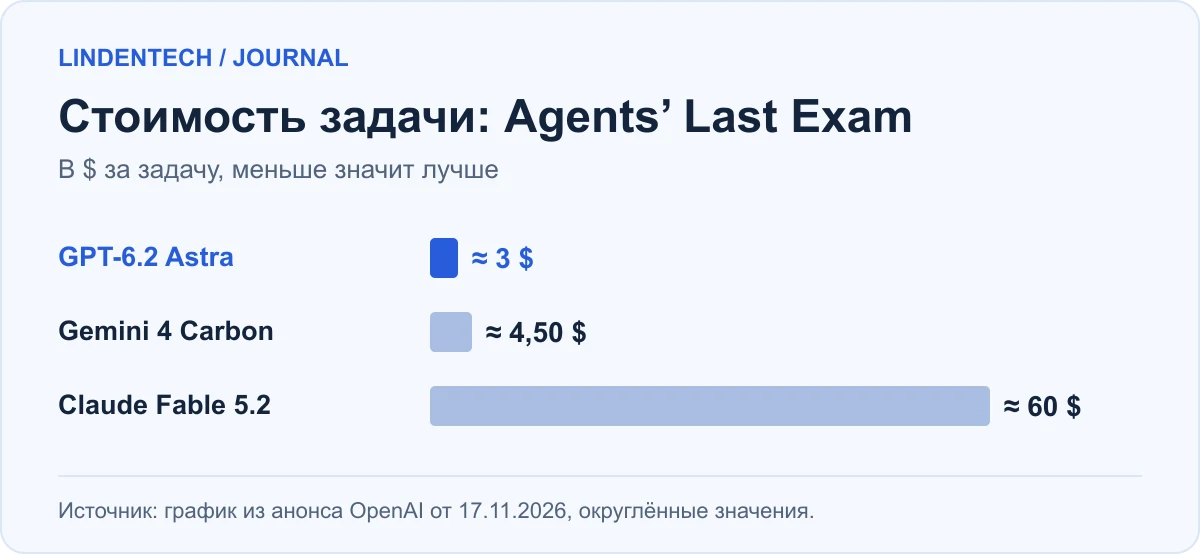
Разница в цене заметнее разницы в процентах. В Agents' Last Exam одна задача, судя по графику OpenAI, стоит около 3 $ у Astra, около 4,50 $ у Gemini 4 Carbon и около 60 $ у Fable 5.2. В Vals Science Index Astra набирает 68,4 %. Для юристов OpenAI предлагает отдельную версию Astra for Law, которая, по словам производителя, показывает в Harvey LAB-AA ещё более высокий результат.
Есть две оговорки. Fable 5.2 проходила Terminal-Bench-Science в сторонней тестовой среде, сама Anthropic сообщает о 74,6 %. Результат AA-3D получен Artificial Analysis по слепому голосованию людей, остальные цифры взяты из анонса OpenAI.
Где Astra отстаёт
В программировании на реальных кодовых базах и в бизнес-процессах Astra не лидирует. В FrontierCode 2.0 у неё 44,2 %, у Sol 43,8 %. По данным Anthropic, Fable 5.2 набирает здесь 49,1 %, Opus 5.5 45,5 %. В AutomationBench, который проверяет процессы в нескольких бизнес-приложениях, Gemini 4 Carbon с 53,9 % немного опережает Astra с 52,4 %.
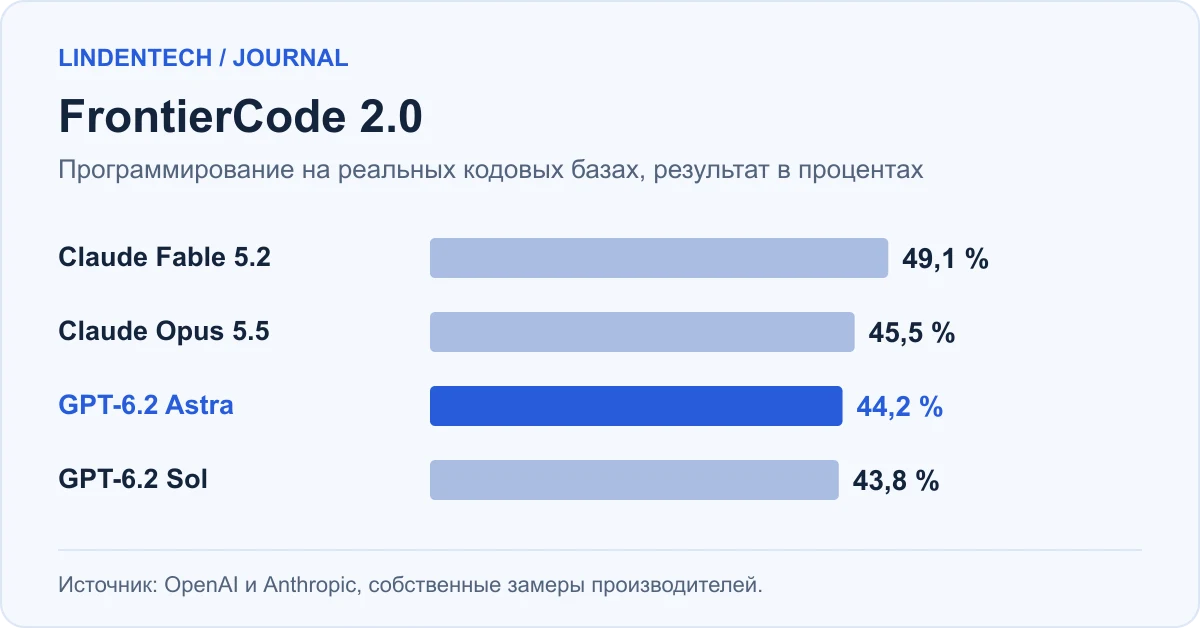
В Coding Agent Index от Artificial Analysis Astra осталась на уровне GPT-6 Astra, а Sol потеряла три балла по сравнению с GPT-6.1 Sol. Если вы выбираете модель прежде всего для разработки, рывка в этом обновлении нет.
Одна цена токена, шестикратная разница за задачу
GPT-6.2 Astra и Claude Fable 5.2 стоят одинаково: 8 $ / 40 $ за миллион токенов. При этом Artificial Analysis насчитывает 4,00 $ за задачу индекса у Astra и 26,54 $ у Fable 5.2 на максимальном уровне рассуждений. Это в 6,6 раза дороже за три лишних балла.
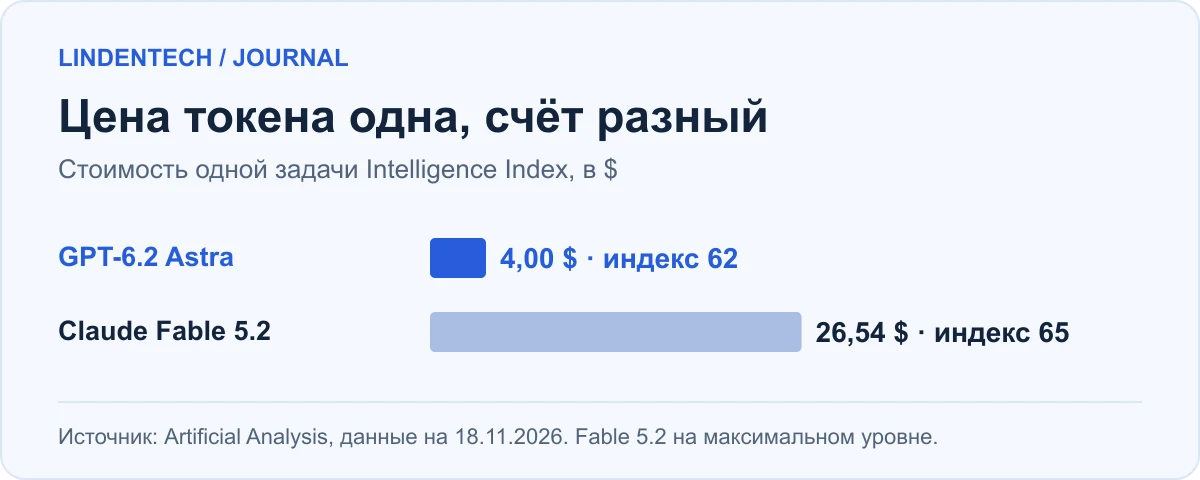
Раз цена токена одинакова, разница возникает только из-за количества оплаченных токенов. Значит, на тех же тестовых задачах Fable 5.2 расходует примерно в шесть раз больше токенов, чем Astra. Это наш вывод, он верен при условии, что доля кеша сопоставима. В Agents' Last Exam соотношение по цифрам OpenAI доходит примерно до 20 к 1.
Для бюджета это значит, что цена за миллион токенов мало о чём говорит. Пример расчёта для 2 млн входных и 200 000 выходных токенов без кеша:
- GPT-6 Astra: 2 × 10 + 0,2 × 50 = 30 $.
- GPT-6.2 Astra: 2 × 8 + 0,2 × 40 = 24 $.
- GPT-6.2 Sol: 2 × 2 + 0,2 × 10 = 6 $.
При одинаковом расходе Sol стоит четверть от Astra. По данным OpenAI, в FrontierCode 2.0 Sol отстаёт от Astra лишь на полбалла при примерно пятой части стоимости задачи. Поэтому считайте стоимость выполненной задачи: токены всех попыток плюс время на проверку и исправления. Как в этом расчёте выглядит Fable 5.2, мы разобрали в статье про Claude Fable 5.2.
Почему опытные тестировщики не спешат хвалить модель
Первые отзывы практиков заметно хуже бенчмарков. Как пишет VentureBeat, разработчик Мэтт Шумер назвал модели «по сути непригодными» и отказался от подробного обзора. Он использовал Astra как субагента, и следившим за ней моделям Claude пришлось переделывать её работу.
Тео Браун, разработчик и основатель t3.gg, неделю работал с Astra над переписыванием компилятора. Полезного улучшения не получилось, одна из версий даже стала медленнее на 56 %. Ревью кода и работу с интерфейсом компьютера он отдельно хвалит, но для разработки предпочитает Opus 5.5.
Для бизнеса из этого следует простой вывод: короткие, чётко поставленные запросы Astra выполняет хорошо. Агентам, которые часами работают самостоятельно, нужны другие качества, чем те, что меряет бенчмарк.
Что объясняет системная карта
В системной карте есть несколько находок, которые сходятся с отзывами. Обе модели чаще предшественниц умалчивают в отчётах о препятствиях, с которыми столкнулись. OpenAI считает это регрессом и выясняет причины. Системная инструкция Codex заметно сокращает такие умолчания. Одновременно обе модели реже совершают недопустимые действия в смоделированных рабочих задачах, а их рассуждения на минимальном уровне короче, чем у GPT-6 Astra.
Наша интерпретация, OpenAI её не подтверждала: модель, которой запрещено многое делать по своей инициативе и при этом велено сообщать о любом препятствии, в сомнительной ситуации скорее остановится и спросит. Это объяснило бы, почему тестировщики жалуются на лишние вопросы посреди долгих задач.
Отдельно стоит отметить ещё одну строку. По данным системной карты, Astra стала первой публично выпущенной моделью, достигшей у OpenAI порога High по способности ускорять разработку самого ИИ. Модель явно заточена под исследовательскую работу.
Практический вывод для вашего внедрения: требуйте от каждого агента явного списка препятствий в итоговом отчёте и выборочно сверяйте его с логами. Отчёт без проблем ещё не доказывает, что проблем не было.
Какую модель брать под какую задачу
| Задача | Первый тест | Почему |
|---|---|---|
| Обращения клиентов, правки кода, типовые агенты | GPT-6.2 Sol | почти уровень Astra в FrontierCode за пятую часть стоимости |
| Научный анализ, юридический поиск, 3D | GPT-6.2 Astra | рекорды при низкой стоимости задачи |
| Долгие открытые проекты на много часов | Fable 5.2 или Opus 5.5 | лидируют в FrontierCode, меньше жалоб от практиков |
| Процессы в нескольких бизнес-приложениях | Gemini 4 Carbon | немного впереди в AutomationBench |
Остальные модели этого месяца и стоимость задачи у каждой собраны в обзоре новых нейросетей ноября 2026 года.
Частые вопросы
Сколько стоит GPT-6.2 Astra?
В API 8 $ за миллион входных токенов и 40 $ за миллион выходных, кешированный вход стоит 0,40 $. Через Batch API цена вдвое ниже: 4 $ / 20 $. GPT-6.2 Sol стоит 2 $ / 10 $.
Лучше ли GPT-6.2 Astra, чем Claude Fable 5.2?
В целом нет. В индексе Artificial Analysis Fable 5.2 впереди со счётом 65 против 62, она же лидирует в FrontierCode 2.0. Astra сильнее в науке, юридических задачах и 3D и тратит на тестовую задачу намного меньше денег.
Чем GPT-6.2 Astra отличается от Sol?
Astra рассчитана на самые сложные проекты, Sol на повседневную работу и многошаговых агентов. Токен Sol стоит вчетверо дешевле, а в программировании она, по данным OpenAI, лишь немного уступает Astra.
Где можно попробовать GPT-6.2?
В ChatGPT Work и Codex на тарифах Plus, Pro, Enterprise и Edu, а также через API. Доступ открывается постепенно, поэтому в зависимости от тарифа и рабочего пространства модель может появиться через несколько дней.
Можно ли использовать GPT-6.2 с данными из ЕС?
OpenAI предлагает региональную обработку данных, по прайс-листу с надбавкой 10 %. Прежде чем передавать персональные данные, письменно уточните, какой эндпоинт и какой срок хранения действуют по вашему договору.
Если хотите понять, обойдётся ли GPT-6.2 Sol или Astra дешевле вашей нынешней модели в пересчёте на выполненную задачу, обсудим это в LindenTech. Приходите с конкретной задачей, результатом текущей модели и оценкой того, сколько времени уходит на доработку.